Search Consoleのサイトマップ「取得できませんでした」の原因と対処|URL・形式・robots.txt・サーバー応答の4層切り分け
Search Consoleでサイトマップが「取得できませんでした」「読み込めませんでした」と出る原因を、URL・形式・robots.txt・サーバー応答の4層で切り分けます。保留・検出0件との見分け方、待つべき期間、技術的に正常でも消えない時の考え方まで解説します。
この記事のポイント
- サイトマップの「取得できませんでした」は、本当の失敗ではなくGoogle側が未処理なだけの状態でも表示される。
- 送信から数日以内で、URLの直接表示とURL検査のライブテストが正常なら、触らずに待つのが正しい判断になる。
- 原因はURL・形式・robots.txt・サーバー応答の4層を上から順に調べると、当日中に特定できる。
- 4層とも正常でも消えない場合は、Googleのクロール需要や品質評価の問題として扱い、修正の向け先を変える。
サイトマップを送信したのに、Search Consoleに「取得できませんでした」と出たまま動かない。ここで慌ててsitemap.xmlを作り直したり、何度も再送信したりすると、本来は待てば済んだ状態をかえって悪くすることがあります。まず確認すべきなのは、その表示が本当に取得失敗なのか、Googleがまだ取りに来ていないだけなのか、という点です。
この記事では、Google Search Consoleのサイトマップ表示を「未取得か、取得失敗か」で切り分け、失敗なら4層(URL・形式・robots.txt・サーバー応答)で原因を潰していく手順をまとめます。技術的に正常なのに消えないケースの考え方まで含めています。
サイトマップの「取得できませんでした」とは?まず失敗か未取得かを見分ける
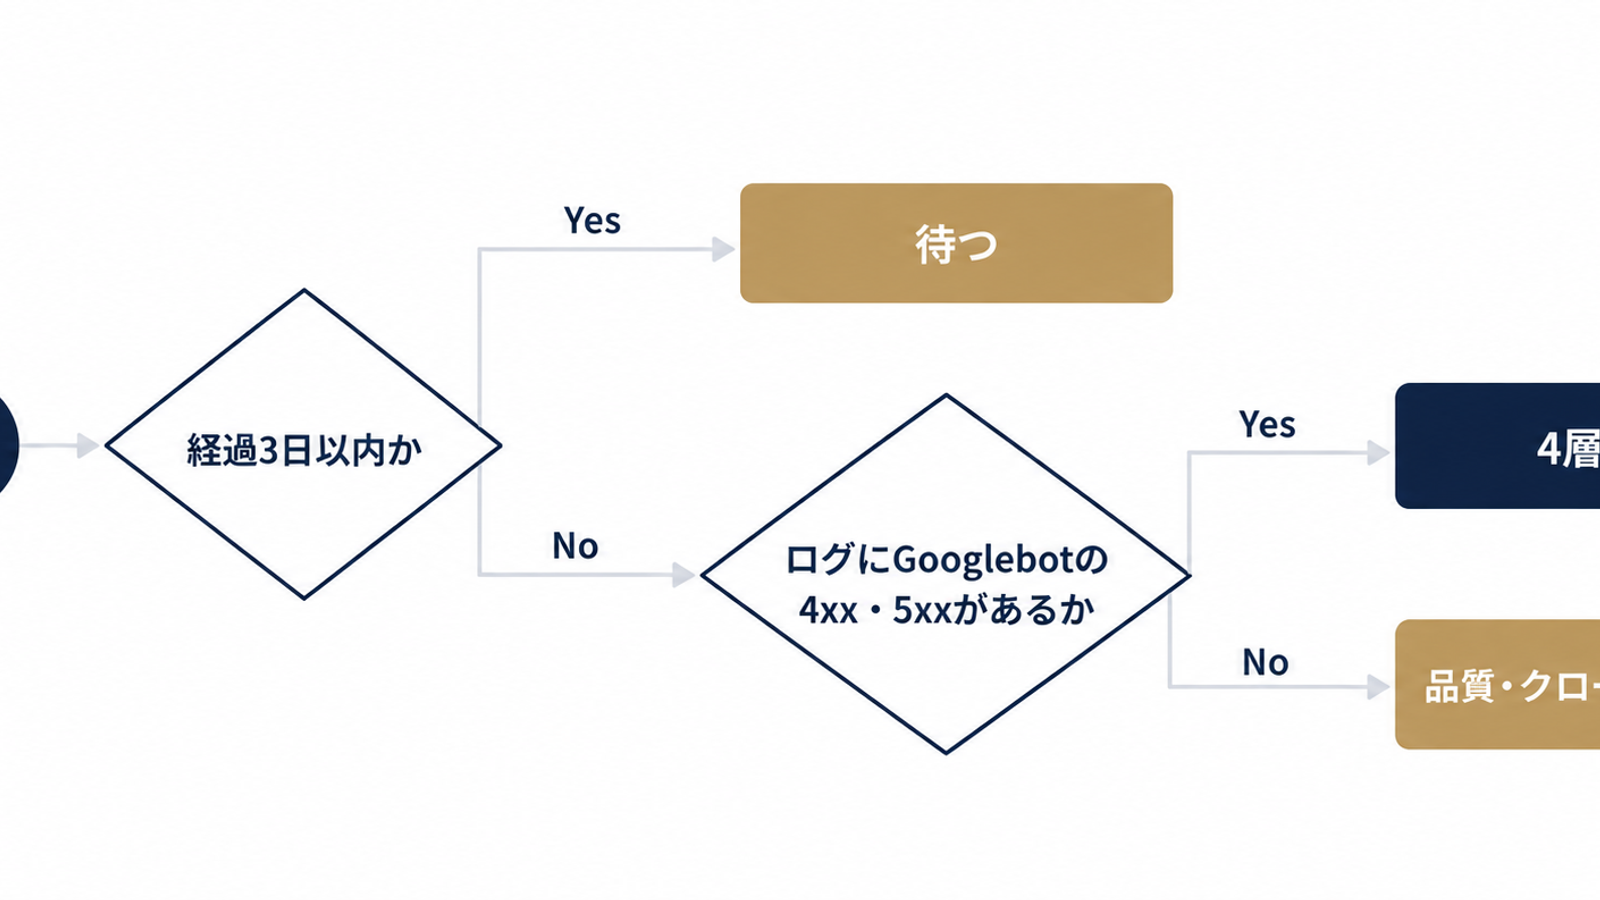 図2: 待つか直すかの判断フロー
 慌てず数日待つ、という判断
Search Consoleのサイトマップ「取得できませんでした」とは、Googleがsitemap.xmlの取得を完了できていないことを示す表示です。ただし、送信直後や未処理の状態でも同じ文言が出る場合があり、表示だけでは失敗と断定できません。
公式のステータス定義(成功・エラーがあります・取得できませんでした)
サイトマップレポートのステータスは、大きく「成功」「エラーがあります」「取得できませんでした」の3種類です。「成功」は取得と解析ができた状態、「エラーがあります」は取得できたが中身に問題がある状態、「取得できませんでした」は取得そのものが完了していない状態を指します。
「保留」「検出されたページ0」と並んで出る意味
「保留」のまま、あるいは「検出されたページ」が0のまま、という表示が並ぶことも多くあります。Search Engine Roundtableの報道によると、2026年4月時点でJohn Muellerは、未処理のサイトマップにも「Couldn’t fetch」と表示される問題について「処理中」ステータスを追加する予定はないと述べています。新規プロパティや送信直後に出る表示は、失敗というより未取得である可能性が高いと読めます。日本の運用でも、送信直後は設定を触らず、状況を記録するだけにとどめた方が安全です。
送信から何日待つべきかの目安と判断表
待つか直すかは、経過日数・検出数・サーバーログの3軸で決めます。以下は公式の保証値ではなく、実務上の判断の目安です。
| 経過日数 | 検出数 | サーバーログ | 判断 |
|---|---|---|---|
| 〜3日 | 0 | Googlebotのアクセスなし | 待つ。URL直接表示だけ確認 |
| 3〜7日 | 0 | Googlebotのアクセスなし | 4層の一次チェックを実施 |
| 1週間超 | 0 | 4xx・5xxで応答 | 直す。第4層から調べる |
| 1週間超 | 0 | 200で取得済み | 品質・クロール需要の層を疑う |
| 任意 | 一部あり | 200で取得済み | 子サイトマップ単位で確認 |
サイトマップが読み込めない原因はどこにある?4層で切り分ける全体像
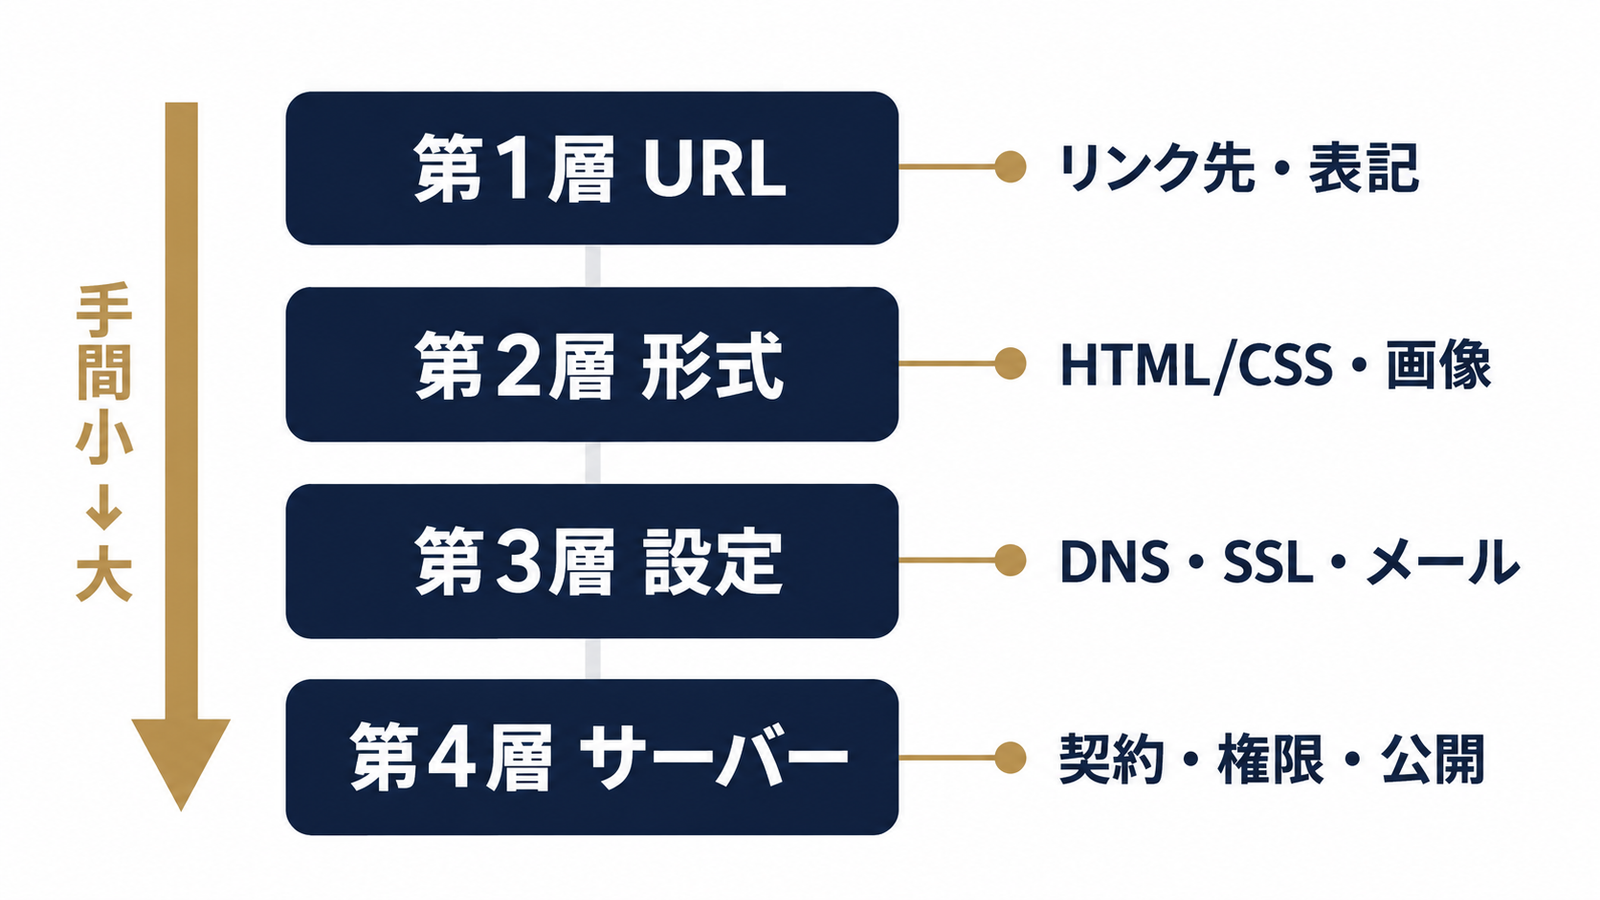 図1: 原因を上から潰す4層構造
原因は、送信したURL、sitemap.xmlの形式、robots.txtなどの設定、サーバーの応答という4層に分けると、上から順に潰せます。下の層ほど調査に手間がかかるため、手間の小さい層から確認するのが最短です。
第1層 URL     : 送信URLとプロパティが一致しているか
第2層 形式    : XMLが正しく、上限内か
第3層 設定    : robots.txt・noindex等で止めていないか
第4層 サーバー: Googlebotに200を返しているか(WAF・CDN含む)
上の層から潰すと早い理由
第1層のURL違いは、ブラウザで数十秒あれば確認できます。第4層のWAFやログ調査は、管理画面やサーバーに入る必要があり、時間がかかります。しかも第1層の不一致が原因なら、第4層をいくら調べても無駄になります。調べやすい順に消していくのが、結果として最短です。
5分でできる一次チェック(ブラウザ表示・シークレットウィンドウ)
まず、送信したサイトマップのURLを、シークレットウィンドウで直接開いてください。ログイン状態に依存せず、第三者と同じ見え方になります。XMLのツリーまたはソースが表示され、リダイレクトが起きず、404や403にもならなければ、第1・2層はほぼ通っています。ここで空白ページ、ログイン画面、HTMLのエラー画面が出るなら、すでに原因が見えています。
第1層:送信したサイトマップのURLは正しいか
第1層では、Search Consoleのプロパティと送信URLが一致しているか、リダイレクトや404が挟まっていないかを確認します。ドメインの表記が1文字違うだけで、取得できない状態になります。
www有無・http/httpsとプロパティ種別の一致
URLプレフィックス型のプロパティでは、https://example.com/ と https://www.example.com/ は別のプロパティです。サイトマップのURLも、そのプロパティ配下のものを送る必要があります。Shopify Communityには、URLプレフィックス型からドメインプロパティに切り替えて解消したという報告があります。逸話レベルの情報ですが、プロパティ単位のずれは日本の中小サイトでも起きがちなので、サーチコンソールの所有権確認ができない時の手順は、サーチコンソールの所有権確認ができない時の手順でプロパティ種別の選び方とあわせて確認してください。
末尾スラッシュやリダイレクトが挟まっていないか
送信URLがリダイレクトを経由していると、Googleは最終URLを別物として扱います。httpからhttps、wwwなしからwwwありへの転送が残っている場合は、転送先のURLを正として送り直します。サイトマップ内のURLにリダイレクト元が混じっている場合は、「ページにリダイレクトがあります」の直し方も参考になります。
WordPressプラグインごとのサイトマップURLの違い
WordPressでは、使うプラグインによってURLが異なります。
| 仕組み | 代表的なURL |
|---|---|
| WordPress標準のXML Sitemaps | /wp-sitemap.xml |
| Yoast SEO | /sitemap_index.xml |
| Rank Math | /sitemap_index.xml |
プラグインを入れ替えた後も、古いURLを送り続けている例は少なくありません。複数のプラグインが同時に有効だと、サイトマップが競合して404になることもあります。どれか1つに絞ってください。
第2層:sitemap.xmlの形式・中身にエラーはないか
第2層で見るのは、XMLとして正しく読めるか、上限を超えていないか、掲載URLがプロパティと一致しているかです。見た目が正常でも、ごく小さな混入物で解析が失敗します。
先頭の空白・BOM・PHPの出力混入
XML宣言の前に空白、改行、BOMがあると、パーサーが失敗する場合があります。WordPressではテーマのfunctions.phpやプラグインの閉じタグ?>の後ろの改行が、出力に混じる典型的な原因です。ブラウザの「ページのソースを表示」で、1行目が<?xmlから始まっているかを見てください。Content-Typeがtext/htmlになっていないかも、次のcurlで確認できます。
5万URL・50MBの上限とサイトマップインデックスの入れ子禁止
サイトマップ1ファイルの上限は、5万URLまたは非圧縮で50MBです。超えるなら分割し、サイトマップインデックスにまとめます。サイトマップインデックスとは、複数のサイトマップのURLを列挙した親ファイルのことです。インデックスの中に別のインデックスを入れる入れ子は認められていません。分割するときは、インデックス1枚の直下に子サイトマップを並べる形にしてください。
掲載URLの階層・ドメインの不一致
サイトマップに載せたURLは、サイトマップの置き場所と同じドメインでなければなりません。ステージング環境のURLが残ったままだと、本番で読み込まれません。リニューアル後にURLがずれるのも同じ原因で、設計の見直しにはURL構造を変えるときの301リダイレクト設計が役立ちます。
第3層:robots.txtや設定でブロックしていないか
第3層では、robots.txtのDisallow、noindexの設定、CMSの検索エンジン表示設定によって、取得や登録を止めていないかを確認します。意図せず残っていた設定が原因のことがよくあります。
robots.txtのDisallowとSitemap行
/robots.txtを開き、Disallow: /が全体に効いていないか、サイトマップのパスがDisallow対象になっていないかを見ます。公開前のサイトで入れた全面ブロックが、公開後も残っているケースは典型的です。あわせて、Sitemap: https://example.com/sitemap.xmlの行が正しいURLを指しているかも確認してください。
WordPressの「検索エンジンがサイトをインデックスしないようにする」
WordPressの「設定」→「表示設定」にある、「検索エンジンがサイトをインデックスしないようにする」にチェックが入っていると、noindexが出力され、環境によってはrobots.txtにも影響します。制作中に入れたチェックを外し忘れていないか、まず見てください。
URL検査ツールのライブテストで確認する
URL検査ツールとは、Search Console上で特定URLのGoogleから見た状態を確認する機能です。サイトマップのURL自体を入力し、「公開URLをテスト」を実行します。「URLはGoogleに登録できます」と出れば、Googlebotはそのファイルを取得できる状態です。ブロックされている場合は、理由がここに表示されます。
第4層:サーバーはGooglebotに200を返しているか
 ログを見て応答を確かめる
第4層では、サーバーがGooglebotに200とXMLを返しているかを確認します。ブラウザでは見えるのに、Googlebotにだけ403や429、あるいは遮断ページを返している、という状態がここで見つかります。
curlでステータスコードとContent-Typeを見る
curl -I https://example.com/sitemap.xml
curl -I -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/sitemap.xml見るのは、ステータスコードが200か、Content-Typeがapplication/xmlまたはtext/xmlか、の2点です。User-AgentをGooglebotに変えて結果が変わるなら、Bot判定で出し分けている疑いがあります。ただし、User-Agentの偽装だけでは、IP検証付きのWAFの挙動までは再現できません。最終判断はログで行います。
Cloudflare等のBot対策・WAFのレート制限
CDNやWAFがGoogleのクロールを弾く仕組みは、広告審査でも同じ論点になります。WAFや海外IP制限でGoogleのBotが弾かれる仕組みも合わせて読むと全体像がつかめます。
Gautam Khoranaの個人検証記事(公式手順ではありません)では、WAFのIP単位のレート制限が、インデックス読込直後の子サイトマップへの集中アクセスを弾いた事例が紹介されています。Cloudflareなら、セキュリティのイベントログで、Googlebotらしきアクセスのブロックや、チャレンジの有無を確認できます。日本のCloudflare導入サイトでも、Bot対策を強めた後にサイトマップだけが読まれなくなる、という構図は十分に起こりえます。
サーバーログでGooglebotのアクセス有無を確認する
アクセスログで、サイトマップのパスとGooglebotを検索します。見るべきは次の3パターンです。
- アクセス自体がない:Google側が未取得。待つか、第1〜3層に戻る
- 4xx・5xxで応答している:サーバー側の問題。WAF・CDN・キャッシュを調べる
- 200で応答している:技術層は正常。次の層へ進む
Googlebotを名乗る別物の可能性があるため、IPの逆引き検証も併用してください。
4層とも問題ないのに消えない時は何が起きている?
4層がすべて正常でも「取得できませんでした」が残る場合、原因はサイト側の不具合ではなく、Google側の負荷、クロール需要、品質評価にあると考える段階です。技術修正を重ねても直らないなら、リソースの向け先を変えるべきです。
2026年のMueller発言:負荷とクロール需要
PPC Landは、Search Off the Record第114回(2026年10月1日公開)の解説で、Muellerが次のように説明したと報じています。XMLが正しく到達可能なサイトマップでも、Google側の負荷(ホストロード)や、クロール需要の低さによって「Couldn’t fetch」になりうる。しかもクロール需要は、サイトの品質がどう見えているかに強く左右される、という内容です。
Search Engine Journalも、サーバーログではGooglebotが200でサイトマップを取得しているのに、Search Consoleでは「Couldn’t fetch」と出る事例を紹介しています。Muellerは、新しく重要なコンテンツがあるとGoogleが確信できなければ、サイトマップは使われないと答えたとされます。ログが200なのに表示が失敗なら、技術層ではなく品質層の問題と読むのが妥当です。
一度失敗したURLへのバックオフと、別URLで再送信する選択肢
Gautam Khoranaの検証記事では、WAFを直した後も、Googleが同じURLへのバックオフ(再試行の間隔を空けること)を続けたとされています。Search Console Sitemaps APIでisPending=trueかつlastDownloadedがない場合は、一度も取得を試みていないと判別でき、クエリ付きの別URLで再送信すると即座に処理された、という報告です。個人検証であり公式の手順ではないため、本番でいきなり試す前に、元のURLを残したまま別URLを追加する形で影響を見てください。
インデックス登録レポートで実際の登録状況を見る
サイトマップの表示だけを見ていても、本当の状態は分かりません。「ページのインデックス登録」レポートで、実際の登録数と除外理由を見てください。サイトマップが読まれているのに増えないなら、「検出 - インデックス未登録」が減らない原因と対処や、記事単位の見極めに使える「クロール済み - インデックス未登録」の判断基準に進みます。
修正後の再送信と、再発を防ぐ運用
再送信は、原因を修正してから1回だけ行うのが原則です。修正前の再送信や連打は、状況を変えないまま履歴を増やすだけです。
再送信は「修正してから」1回だけ
手順は次の通りです。
- 原因の層を特定し、修正する
- ブラウザとcurlで、200とXMLの正常表示を確認する
- URL検査のライブテストで、取得可能を確認する
- Search Consoleのサイトマップから、該当URLを1回再送信する
- 数日待ち、検出数とログのアクセスを確認する
改善しなければ、前節の別URLでの送信を検討します。
サイトリニューアル・サーバー移転時のチェック項目
構造が変わる作業の前後は、サイトマップが壊れやすい時期です。リニューアルや移転の際は、次の項目を点検してください。
- サイトマップのURLとプロパティ(www有無・https)が一致しているか
- robots.txtにステージング用の全面ブロックが残っていないか
- WAF・CDNのBot対策やレート制限が、Googlebotを弾いていないか
- 旧URLから新URLへの301リダイレクトが通っているか
- サイトマップ内のURLが、リダイレクト先ではなく最終URLになっているか
月次でも、サイトマップのステータスと、ログ上のGooglebotのアクセスを確認しておくと、異常に早く気づけます。
よくある質問
Q:サイトマップを送信した直後に「取得できませんでした」と出るのは失敗ですか?
多くは未処理の状態で、失敗とは限りません。数日待ち、サイトマップURLの直接表示とURL検査のライブテストで問題がなければ、様子見で構いません。1週間を超えても動かない場合に、4層の切り分けを始めてください。
Q:サイトマップのステータスが「成功」なのに検出されたページが0なのはなぜ?
サイトマップインデックスだけが読まれ、子サイトマップがまだ取得されていないケースがあります。また、サイトマップ内のURLがプロパティと一致していない場合も、検出数は0になります。子サイトマップ単位のステータスと、掲載URLのドメインを確認してください。
Q:何度も再送信すれば早く読み込まれますか?
再送信の連打は、効果が薄いと考えられます。原因を修正した後に1回だけ送信し、Google側の通常の再試行を待つのが基本です。
Q:サイトマップを送信しないとインデックスされませんか?
必須ではありません。Googleは内部リンクをたどってもページを発見します。サイトマップは、大規模サイトや公開直後の新規サイトで発見を助ける補助手段です。
Q:Cloudflareを使っているとサイトマップが取得されないことはある?
あります。Bot対策やレート制限が、Googlebotのアクセスを弾く例が報告されています。サーバーログのステータスと、CloudflareのセキュリティイベントでGooglebotのアクセスが遮断されていないかを確認してください。
Q:サイトマップは読み込まれたのにページがインデックスされないのはなぜ?
サイトマップの読み込みと、インデックス登録は別の処理です。サイトマップは、ページをGoogleに知らせる手段にすぎません。「ページのインデックス登録」レポートで、「検出 - インデックス未登録」などの除外理由を確認し、そちらの側で対処します。
サイトマップの表示は、4層の切り分けを経ても原因が見えにくいことがあります。真策堂では、こうした観点でSearch Consoleの状況整理やサイト改善のご相談を受けています。判断に迷う場合は、お気軽にお問い合わせください。
- SEO・コンテンツ戦略
「検出 - インデックス未登録」が増える・減らない原因と対処|「クロール済み」との違いと放置してよいURLの見分け方
Search Consoleの「検出 - インデックス未登録」が減らない原因を、クロール容量と需要の2分岐で切り分けます。クロール済みとの違い、放置してよいURLの判断表、新規記事が反映されない時のリクエストの使い方、待つ期間の目安まで、当日中に方針を決められる手順で解説します。
- SEO・コンテンツ戦略
「重複しています。Googleにより、ユーザーがマークしたページとは異なるページが正規ページとして選択されました」の原因と対処|放置してよいURLと直すべきURLの見分け方
Search Consoleの「重複しています。Googleにより、ユーザーがマークしたページとは異なるページが正規ページとして選択されました」は、多くの場合そのままで問題ないと思います。URL検査ツールで見る2行、放置・修正の判断表、canonicalが無視される原因の切り分け、シグナルの揃え方、修正後の待ち方まで整理しました。
- SEO・コンテンツ戦略
「ページにリダイレクトがあります」は放置していい?直すべきURLの見分け方と直し方
Search Consoleの「ページにリダイレクトがあります」はエラーではなく多くは正常動作です。放置してよいURLと直すべきURLの判断表、サイトマップ照合による5分の仕分け、チェーン・302・意図しない転送の直し方、広告計測への波及チェックまで当日中に対処できる実務手順で解説します。