新宿のGoogle広告 除外キーワードの決め方|隣の駅名・エリア名を除外するか残すかの判断表
新宿でGoogle広告を出すとき、代々木・新大久保・渋谷など隣の駅名や、東新宿・西武新宿のように新宿を含む駅名を除外すべきかを判断表で整理。地域ターゲティングとの役割分担、地名はフレーズ一致で登録する理由、表記ゆれの確認、検索語句レポートで地名ごとの費用を集計する手順までまとめました。
この記事のポイント
- 新宿のGoogle広告で地名を除外するときは、除外・保留・受け皿化の3択で仕分けるのが基本です。
- 徒歩圏の駅名は残し、来店が見込めない地名だけをフレーズ一致で除外するのが新宿の地名除外の定石です。
- 地域ターゲティングは人の所在地、除外キーワードは検索の中身を止める別の仕組みで、役割を分けて設定します。
- 除外の前に検索語句レポートを地名単位で集計し、費用とCVを見てから決めれば、当日中に除外リストを作れます。
新宿の店舗でGoogle広告を回していると、「新宿 業種」の検索語句に混じって、代々木、新大久保、渋谷、池袋といった駅名つきの検索が並びはじめます。地名キーワードは組んだ。それなのに、来店できない距離の駅名検索にクリック費が流れている。しかも「東新宿」や「西武新宿」のように、「新宿」の文字を含む別の駅名まで混ざっているため、不用意に除外すると主力の「新宿」まで巻き込みそうで手が止まる。多くの担当者がここで止まります。
この記事は、新宿のGoogle広告で、除外キーワードに入れる地名と残す地名をどう決めるかに絞って整理します。キーワードの掛け合わせ側は別記事に任せ、ここでは除外側の判断だけを扱います。読み終えたら、検索語句レポートを開いて、地名の除外リストを当日中に作れる状態を目指します。

新宿のGoogle広告では、どの地名を掛け合わせて、どの地名を除外すればいい?
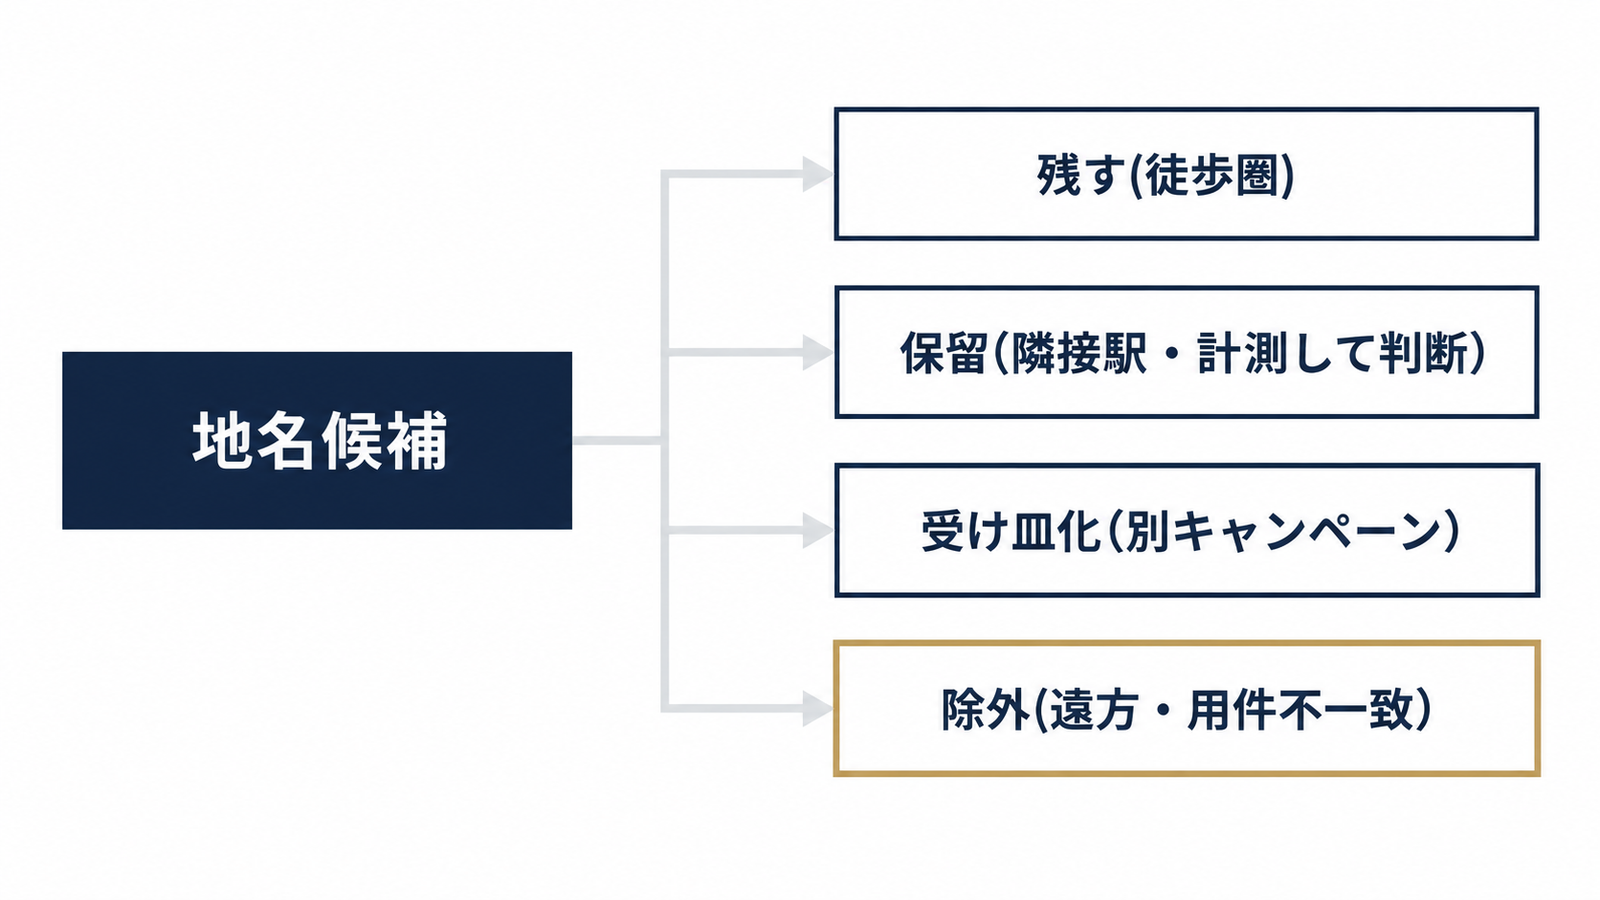 図1: 地名は4つの仕分けで判断する
来店できる範囲の駅名・町名は残し、来店が見込めない地名だけをフレーズ一致で除外するのが、新宿のGoogle広告における地名設計の基本です。残す・外すの線は、感覚ではなく、自社の商圏と来店動線で引きます。
先に結論:除外・保留・受け皿化の3択で仕分ける
地名を「除外するか残すか」の二択で考えると、判断が荒くなります。実務では次の3択で仕分けると整理しやすくなります。
| 仕分け | 対象の例 | 考え方 |
|---|---|---|
| 残す(そのまま配信) | 新宿三丁目・西新宿・新宿御苑前など徒歩圏 | 来店動線に入るので、通常のキャンペーンで取りにいく |
| 保留(計測してから決める) | 代々木・新大久保・渋谷・池袋など隣接駅 | 業種と動線しだい。検索語句レポートで費用とCVを見る |
| 受け皿化(別キャンペーンで受ける) | エリア外から「新宿+用件」で探す人 | 除外せず、費用とCVを分けて見られる箱を作る |
| 除外する | 来店が成立しない遠方の地名、用件の合わない地名 | フレーズ一致で登録する |
ここでの除外は「どうせ関係ない」で決めるものではありません。保留の欄を作っておくことで、迷う駅名を数字で判定する余地が残ります。
掛け合わせる地名の4層(新宿・駅名・町名や通称・隣接駅)の要点だけ復習
掛け合わせる地名は、「新宿」そのもの、駅名、町名や通称、隣接駅の4層で考えます。除外の判断はこの4層と対応するため、ここだけ押さえておけば十分です。詳しい作り方は新宿のキーワード選定(4層フレーム)に譲ります。
除外側で効いてくるのは、第4層の隣接駅と、第2層の駅名のうち「新宿」を含むものです。前者は来店圏から外れるかどうか、後者は除外の仕組み上、主力の「新宿」を巻き込む恐れがあるかどうかが論点になります。次章以降で順に見ていきます。
地域ターゲティングと除外キーワードの違いは?どちらで止めるべきか
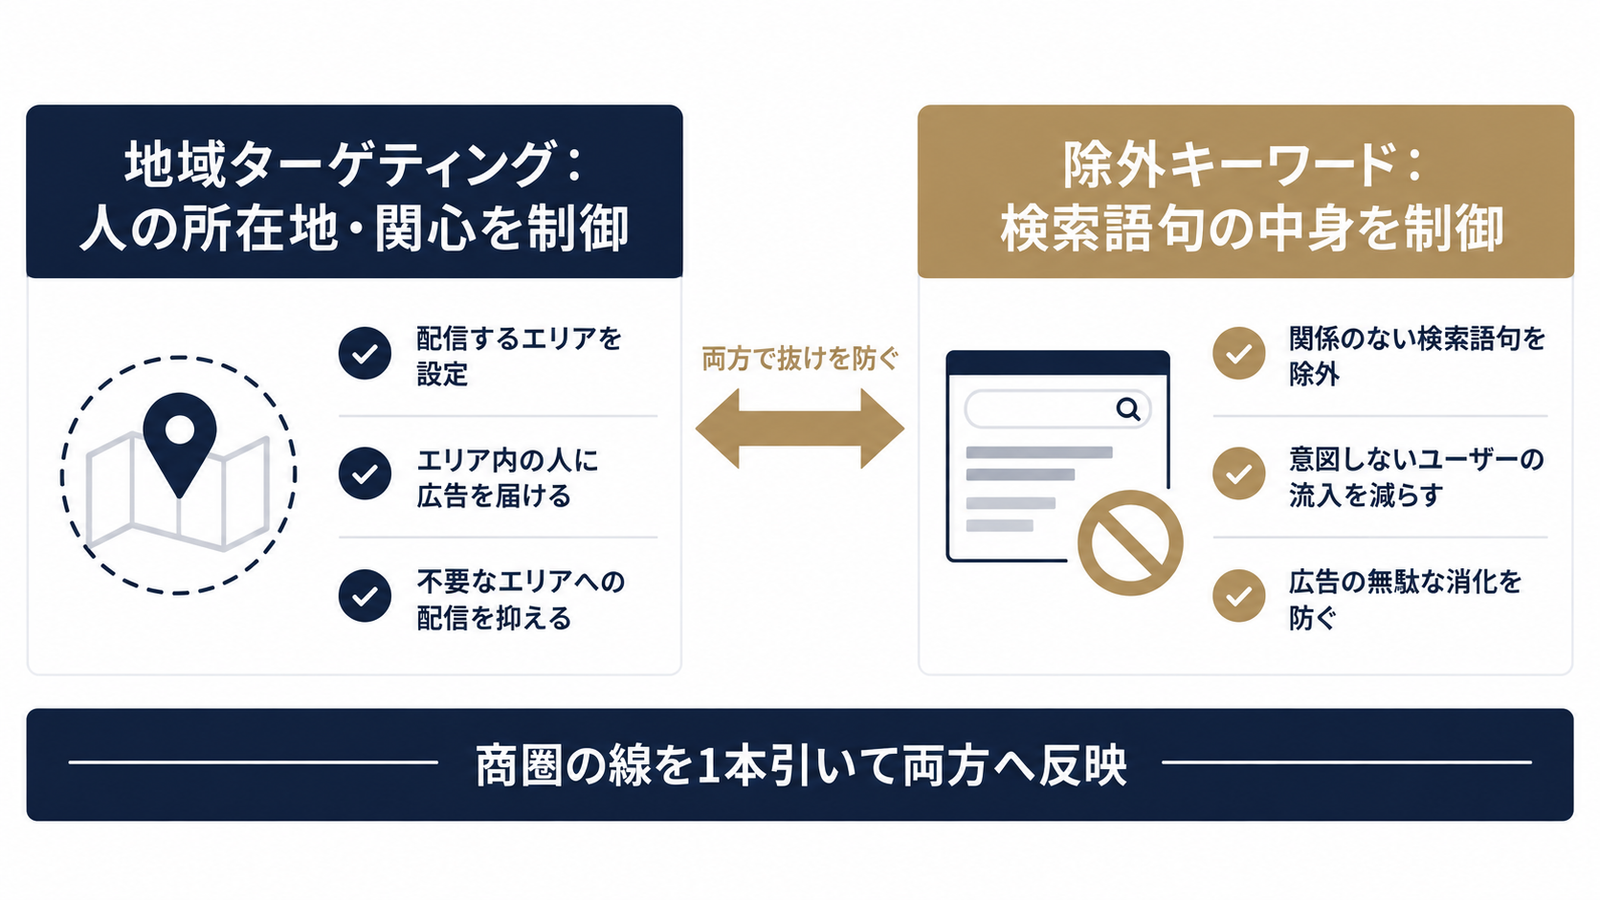 図2: 人を止めるか、言葉を止めるか
地域ターゲティングは「広告を見る人がどこにいるか・どこに関心を持つか」を制御し、除外キーワードは「検索語句に何が含まれるか」を制御します。人の場所で止めたいなら地域設定、検索の中身で止めたいなら除外語句、と役割を分けるのが原則です。
地域設定で止まるもの・止まらないもの
地域ターゲティングとは、Google広告で広告を表示する地域を指定する設定です。所在地オプションの選び方によって、「その地域にいる人」だけに絞るのか、「その地域に関心を示した人」まで含めるのかが変わります。
ここに誤解が生まれやすい点があります。地域設定で新宿に絞っていても、新宿にいる人が「渋谷 業種」と検索すれば、その検索語句に反応して広告が出ることがあります。逆に、新宿の外にいる人が「新宿 業種」と検索することも、設定次第では起きます。地域設定は人を止め、除外語句は言葉を止める。このため、片方だけでは抜けが出ます。
商圏外からのクリックを減らす地域側の手当ては、新宿の商圏外クリックを減らす地域設定で整理しています。一方、地名を含む検索そのものを止めたいときに使うのが、本記事の除外キーワードです。
配信半径と地名キーワードの線を揃える
海外では、配信半径と地名の語句を別々に決めず、商圏の線を先に1本引いてから両方に反映させる考え方が紹介されています。Search Engine Land の「9 essential geotargeting tactics for Google Ads」では、半径の外にある地名へ入札しても意味が薄いため、地名キーワードと地名の除外は配信半径と揃えて設計する、という趣旨の指摘があります。
日本の新宿に当てはめると、この考え方は特に効きます。新宿は半径1km程度に複数の駅名商圏が入り込み、地域設定と語句の線がズレやすいからです。たとえば半径を広めに取っているのに、隣接駅の語句だけ全部除外してしまう。あるいは半径を絞っているのに、半径外の駅名を掛け合わせたまま放置する。どちらも設計が二重か、抜けになります。
手順としては、まず来店動線から「ここまでは来る」という線を決めます。次にその線の内側の駅名・町名を残す側、外側を除外か受け皿の側に置きます。最後に、その線に合わせて半径や所在地オプションを見直します。半径と所在地オプションの考え方は半径指定と所在地オプションの選び方が参照先になります。
隣の駅名(代々木・新大久保・渋谷・池袋)は除外すべき?
隣の駅名は、徒歩圏で用件が同じなら残し、乗り換えが必要な別商圏なら除外か受け皿化に回すのが基本の分け方です。一律で除外すると、来店につながる検索まで捨てる可能性があります。
徒歩圏の駅名は除外しない
代々木と新大久保は、新宿の店舗から徒歩で行ける距離に収まることが多く、業種によっては来店動線に入ります。たとえば、移動しながら比較検討する業種や、勤務先の近くで予約を取る業種では、「代々木 業種」の検索者が新宿の店舗に来ることは十分あり得ます。
こうした駅名は、除外ではなく「保留」に置いて、検索語句レポートで費用とCVを見ます。見ないまま外すと、取れていたはずの需要を自分で止めることになりかねません。
ターミナル同士の比較検索(新宿 渋谷 など)の扱い
「新宿 渋谷 業種」のように、ターミナル同士を並べた比較検索は、除外の判断が分かれる場面です。この検索者は、どちらで利用するかをまだ決めていない状態です。新宿を選ぶ余地があるため、渋谷という語を含むからといって即除外するのは早計になります。
ここで注意したいのが除外の仕組みです。「渋谷」を部分一致で除外すると、「新宿 渋谷 業種」のような複数地名の検索も止まります。比較検索を取りたいなら、「渋谷 業種」のように語順や組み合わせを限定する、あるいは単独の「渋谷」は除外せず計測を続ける、といった選択になります。ターミナル同士の比較検索は、成約率が下がりやすいと言われることもありますが、これは業種で大きく変わります。自社のデータで確かめるのが確実です。
エリア外から地名つきで探す人を別キャンペーンで受ける選択肢
Search Engine Land の「How to expand your reach with reverse location targeting in Google Ads」では、エリア内にいる人向けと、エリア外から地名つきで検索する人向けにキャンペーンを分け、後者は地名入りのフレーズ一致・完全一致だけで受ける構成が紹介されています。地名を除外する前に、地名検索の受け皿を分けるという選択肢です。
日本市場でも、来街者・出張者・観光客が外から「新宿+用件」で探す場面は多く、除外一択にしない判断材料になります。ただし、同名の地名や、新宿以外の地域にある類似名称には注意が必要です。別キャンペーンに分けることで、費用とCVを切り分けて見られるようになり、「この層は採算が合う」「合わない」を数字で言えるようになります。
「東新宿」「西武新宿」「新宿御苑前」など新宿を含む駅名はどう扱う?
「新宿」を含む別の駅名は、除外の仕組みが語単位で判定されることを踏まえ、主力の「新宿」を巻き込まない形で登録します。東新宿・西武新宿・新宿御苑前・新宿三丁目・西新宿は、いずれも「新宿」を含むため、残すか外すかを駅ごとに決める必要があります。
マッチタイプごとの効き方を公式仕様で確認する
除外キーワードのマッチタイプは、Google広告の公式ヘルプで次のように説明されています(2026年時点の整理)。
| マッチタイプ | 効き方 |
|---|---|
| 部分一致 | 除外語句のすべての語を含む検索で広告が止まる。語順は問わない |
| フレーズ一致 | 除外語句が同じ語順で含まれる検索で広告が止まる |
| 完全一致 | 除外語句と完全に同じ検索のときだけ広告が止まる |
ここで重要なのは、除外キーワードは「新宿」という語を含むかどうかで機械的に判定されるわけではない、という点です。たとえば「東新宿」は表記上ひと続きの語として登録されるため、「東新宿」をフレーズ一致で除外しても、「新宿 業種」という検索には影響しない設計です。逆に、うっかり「新宿」単体を除外に入れると、主力の検索がすべて止まります。
典型的な失敗は、「東 新宿」のようにスペースを入れて登録してしまうケースです。このように登録すると、「新宿 東口 業種」のような検索まで止まる恐れがあります。地名は、駅名として一語で登録するのが安全です。
登録前に検索語句レポートで試し読みする
登録前の確認は、次の順で進めます。
- Google広告の管理画面で、[キャンペーン]→[分析情報とレポート]→[検索語句]を開き、期間を直近30〜90日にする
- 検索語句の絞り込みで、除外候補の駅名(東新宿など)を含む語句を抽出する
- その語句の表示回数・クリック数・費用・コンバージョンを見る
- 「新宿 業種」のような主力の語句が混ざっていないか、一覧を目で読む
この試し読みで、除外候補が実際にどんな語句と一緒に出ているかが分かります。登録後は、その語句の表示回数が落ちているか、主力の「新宿」系の表示が落ちていないかを数日後に見ます。なお、検索語句レポートには、プライバシー保護の観点で表示されない語句もあります。その背景は検索語句レポートに表示されない語句の正体で補足しています。
地名以外に、新宿の店舗が除外しておきたい語句は?
新宿の店舗が地名以外に除外しておきたい語句は、求職系、駅そのものの情報系、自社で扱わない用件・価格帯の3系統です。海外の分類を日本の検索に置き換えると整理しやすくなります。
Whitespark の「Must-Have Negative Keywords for Small Business & Local Adwords Campaigns」は、ローカル事業者の除外を、求人・情報収集・学習・対応外エリア・定番の5カテゴリで型化しています。この型自体は使えます。ただし、郵便番号検索や州の略称といった要素は米国前提で、日本にはそのまま当てはまりません。日本では駅名・町名・通称に置き換えて考えます。
求人・バイト・年収などの求職系
「求人」「バイト」「採用」「年収」「派遣」「正社員」などは、店舗が客を取りたいときにはほぼ不要な語です。ただし、自社が採用に広告を使う場合は別のキャンペーンで扱います。登録するときは、業種名と組み合わさった語(例:「業種 求人」)も候補に入れると取りこぼしが減ります。
行き方・出口・ロッカーなど駅そのものの情報系
新宿は駅の構造が複雑で、「新宿駅 出口」「新宿駅 行き方」「新宿駅 コインロッカー」のように、駅そのものを調べる検索が多く存在します。「新宿」を含むため、地名キーワードの拡張で拾いやすい領域です。こうした検索は用件が合わないことがほとんどなので、「出口」「行き方」「ロッカー」「乗り換え」などの語を、用件リスト側で除外します。ただし、道案内を求める検索が来店直前の人である場合もあるため、業種によっては残す判断もあります。
自社で扱わない用件・価格帯
最後は自社の事業との不一致です。たとえば高価格帯を扱わない店舗が「高級」を拾っていないか、「無料」「格安」を拾っていないか。「ほぼ関連するが成約しない」語句がここに多く混ざります。
Karooya の「Negative Keywords in Google Ads (2026)」は、予算を食うのは明らかな無関係語より、ほぼ関連するが成約しない語句だと指摘し、除外を掃除ではなく流入の振り分け手段と位置づけています。ツール販売元の記事なので数値主張は割り引いて読む必要がありますが、隣の駅名検索はまさにこの「ほぼ関連」の典型です。競合が密集するエリアでクリック単価の無駄を減らす観点は、競合密度の診断とキーワード設計も参考になります。
除外する前に、地名ごとの費用と成果をどう確認する?
 除外の前に、まず数字を確かめる
除外する前に、検索語句を地名単位で集計し、地名ごとの費用とコンバージョンを並べて見ます。除外の基準は一律の数値ではなく、自社の目標CPAで決めます。
検索語句レポートを書き出して地名で集計する
手順は難しくありません。検索語句レポートをスプレッドシートに書き出し、検索語句を単語に分解して、単語ごとに費用・クリック・CVを合計します。これはnグラム分析と呼ばれる手法の簡易版です。
Igor Ivitskiy 氏の個人ブログ「N-Gram Analysis for Google Ads Search Terms: Find Repeated Waste」は、検索語句を単語単位に分解して費用とCVを集計し、繰り返し出る無駄語を見つける方法を紹介しています。新宿の場合、この「単語」を地名に読み替えるだけで使えます。
具体的には、次のような表を作ります。
| 地名 | 検索語句の数 | 費用 | クリック | CV | CPA |
|---|---|---|---|---|---|
| 代々木 | (集計) | (集計) | (集計) | (集計) | (費用÷CV) |
| 新大久保 | |||||
| 渋谷 | |||||
| 池袋 | |||||
| 東新宿 |
CVが0で費用だけが積み上がっている地名は、除外候補です。CVがあって目標CPAに収まる地名は、残す側に回します。
集計は候補、元の検索語句を読んでから決める
同じ Ivitskiy 氏の記事は、集計結果はあくまで候補で、地名やブランド名は文脈で意味が変わるため、必ず元の検索語句を読んでから除外するよう勧めています。一律の閾値はない、という立場です。
これは新宿でもそのまま当てはまります。「渋谷」が費用だけ使っていても、よく読むと「新宿 渋谷 業種」の比較検索が大半で、実はCV直前の検索が多いかもしれません。集計は入口で、判断は元の語句を読んで下します。ここを飛ばすと、数字だけで除外して機会損失を招きます。
地名の除外キーワードはどのマッチタイプで登録する?表記ゆれは?
地名の除外は、語順が保たれるフレーズ一致を基本にします。そのうえで、漢数字・かな・ローマ字などの別表記が抜けていないかを、検索語句レポートの実データで確かめます。
部分一致・フレーズ一致・完全一致の使い分け
地名は一語で完結することが多く、部分一致とフレーズ一致の差が出にくい領域です。それでもフレーズ一致を基本にするのは、複数語の地名や、「新宿」を含む駅名で、意図しない語の組み合わせで止まるのを避けるためです。部分一致は複数語のときに全語を含む検索を止めるため、語順を問わず広く止まります。完全一致は狭すぎ、表記違いや語の追加で簡単にすり抜けます。
誤字は自動で拾われるが類義語や別表記は個別に足す
除外キーワードの挙動は、時期によって変わっています。WordStream の「Updates to Google Ads Search Query Matching in 2025」では、2024年6月の発表で除外キーワードが誤字にも効くようになり、正しい綴りを1つ入れればよくなったと紹介されています。一方で、公式ヘルプの更新が追いついていない時期があったとも指摘しています。
Search Engine Land の「How to tell which Google Ads controls actually control anything」も、除外キーワードは大文字小文字や誤字は自動で拾うが、類義語や単数複数は拾わないという趣旨で整理し、検索語句レポートと除外リストを突き合わせて検証する姿勢を勧めています。
日本語では、これが表記ゆれの問題になります。「新宿三丁目」と「新宿3丁目」と「新宿三丁目駅」、「しんじゅく」とローマ字の「shinjuku」、「西武新宿」と「西武新宿駅」などです。誤字の大量登録に使っていた時間は、こうした別表記や関連語に回した方が効果的です。登録後は、検索語句レポートで同じ地名の別表記が出ていないかを見て、足りない分を追加します。
17語目以降は効かない仕様
除外キーワードの判定には、長い検索語句の末尾が対象にならないという仕様上の制約が知られています。検索語句が長く、除外したい地名が17語目以降に出る場合は、効かないことがあります。日本語の検索は語数が短くなりがちなので、影響は限定的です。ただ、AI Max for 検索のように検索の入口が広がる配信では、長い自然文の検索も増えるため、頭の片隅に置いておきます。効かない場合の切り分けは、除外キーワードが効かないときの確認手順にまとめています。
除外キーワードリストはどう分けて、どの頻度で見直す?
除外キーワードリストは、地名用と用件用に分けて管理し、見直しは立ち上げ直後は短い間隔、安定後は週次を目安にします。リストを分けておけば、どのキャンペーンに何を適用するかを混乱なく管理できます。
地名リストと用件リストを分ける理由
除外キーワードリスト(共有ライブラリ)は、Google広告で複数のキャンペーンに同じ除外語句をまとめて適用できる機能です。地名リストと用件リストを分ける理由は、適用先が違うからです。たとえば、地名リストは商圏の線が違うキャンペーン(来店向けと受け皿向け)で中身を変える必要があります。一方、求職系や情報系の用件リストは、ほとんどのキャンペーンで共通にできます。
テーマ別にリストを分ける考え方は、前述の Karooya の記事でも勧められています。リストの階層設計の詳細は、除外キーワードの共有リスト設計で補完しています。
P-MAX・AI Max併用時の注意
P-MAXでは、通常の検索キャンペーンと除外の仕組みが異なり、使える除外の種類や適用階層に制約があります。AI Max for 検索を有効にした場合は、キーワードに縛られず検索語句が拡張されるため、地名の拡張が起きる可能性があります。この場合、地名の除外が拡張側にも効くか、どの階層の除外が適用されるかを、自アカウントの管理画面とヘルプで確認します。
マッチタイプを広げるほど除外の重要度が上がる点は、インテントマッチをどこまで解放するかでも触れています。AI Max の有効化そのものの判断は、AI Max for 検索の有効化判断が参照先です。
除外しすぎて表示が減ったときの戻し方
除外を入れた後に表示回数やCVが落ちたら、直前に追加した語句から順に戻します。登録した日付をメモしておくか、リストに追加日が分かる運用にしておくと、戻す語句を特定しやすくなります。見直しの頻度は、立ち上げ直後は短い間隔で、安定してから週次にする、というのが海外の実務で語られる目安です。ただ、新宿の店舗で検索量が少ない場合は、週次でも判断材料が足りないことがあります。その場合は、自社の検索量に合わせて間隔を延ばして調整します。
よくある質問
Q:除外キーワードに地名を入れると、その地域にいる人にも広告が出なくなりますか?
止まるのは、その地名を含む検索だけです。人の所在地は地域設定で制御する別の仕組みで、除外キーワードに地名を入れても、その地域にいる人への配信が止まるわけではありません。たとえば「渋谷」を除外しても、新宿にいる人の「新宿 業種」の検索には広告が出ます。
Q:除外キーワードは部分一致とフレーズ一致のどちらで登録すれば良いですか?
地名は、語順が保たれるフレーズ一致が基本です。部分一致は、除外語句が複数語のとき、全語を含む検索だけが止まります。語順は問われないため、意図しない検索まで止まることがあり、地名ではフレーズ一致の方が管理しやすくなります。
Q:除外キーワードを設定したのに、その語句で広告が表示されるのはなぜですか?
主な原因は、類義語や別表記が対象外であること、長い検索語句の17語目以降が判定に効かないこと、除外の適用階層が違うことです。切り分けの手順は、除外キーワードが効かないときの確認手順で詳しく扱っています。
Q:「新宿」を含む別の駅名を除外すると、「新宿 業種」の検索まで止まりませんか?
マッチタイプと登録の仕方しだいです。「東新宿」のように駅名を一語で登録し、フレーズ一致にしておけば、「新宿 業種」を止めない設計にできます。ただし、登録前に検索語句レポートで該当語句を確認し、登録後に主力の「新宿」系の表示回数が落ちていないかを数日後に見る手順を必ず入れてください。
Q:隣の駅名キーワードは、除外せずに入札して取りにいく方が良いですか?
徒歩圏で用件が同じなら、残す価値があります。判断に迷う場合は、別キャンペーンで受けて、費用とCVを分けて見る方法があります。数字が出てから、本キャンペーンに戻すか、除外するかを決められます。
Q:除外キーワードはどれくらいの頻度で見直すと良いですか?
立ち上げ直後は短い間隔で、安定後は週次が目安というのが、海外の実務指針として紹介されています。日本の新宿の店舗でも考え方は同じですが、検索量が少ない場合は週次でも判断材料が不足します。自社の検索量に合わせて間隔を調整します。
地名の除外は、一度決めれば終わる作業ではなく、検索語句の変化に合わせて育てていく設定です。真策堂ではこうした観点から、新宿をはじめとする店舗型ビジネスのGoogle広告について、商圏の線の引き方や除外リストの設計のご相談を受けています。自社の検索語句レポートをどう読めばよいか迷うときは、お気軽にご相談ください。
- Web広告
新宿のGoogle広告は検索とP-MAXどちらから始める?業種と計測状況で決める判断基準
新宿でGoogle広告を始めるとき、検索広告とP-MAXのどちらから着手するかを業種(来店型・問い合わせ型・EC)と計測状況の2軸で整理しました。P-MAXを追加してよいコンバージョン数の目安、高いクリック単価での予算の分け方、代理店提案の確認点までまとめています。
- Web広告
新宿のGoogle広告 キーワードの選び方|東口・西口・町名の掛け合わせとマッチタイプの決め方
新宿でGoogle広告を出すとき、東口・西口などの出口名や西新宿・歌舞伎町などの町名をキーワードに入れるかを、地名の粒度ごとの判断表で整理しました。フレーズ一致・完全一致・インテントマッチの決め方、検索ボリュームが少なくて止まる語の受け方、AI Max利用時の考え方、入稿後の入れ替え手順までまとめています。
- Web広告
Meta広告の画像・テキストが勝手に変わる原因とオフにする方法|Advantage+クリエイティブの補正項目別の確認手順
Meta広告で入稿した画像やテキストが勝手に変わるのは、Advantage+クリエイティブの補正が既定でオンになっているためです。症状から該当項目を逆引きする早見表、広告単位・アカウント単位でオフにする手順、複製や差し替えで設定が戻る原因と解除できない時の確認順、再発を防ぐ点検ルーティンまでまとめました。