「robots.txtによりブロックされましたが、インデックスに登録しました」の原因と対処|noindexとの使い分けと放置してよいURLの見分け方
Search Consoleの「robots.txtによりブロックされましたが、インデックスに登録しました」の原因と対処を解説。放置してよいURLの判断表、robots.txtとnoindexの違い、併用すると消えない理由、広告パラメータURLの扱いまで、当日中に方針を決められる手順でまとめました。
この記事のポイント
- 「robots.txtによりブロックされましたが、インデックスに登録しました」は、クロールは止めたがURLだけ登録された状態であり、多くは放置で済む。
- 放置か修正かは、URLの種類とSearch Consoleの表示回数で決まる。site:検索でしか見えないURLは、直さなくてよい。
- Disallowとnoindexを併用するとnoindexが読まれず、インデックスが消えない。消したい場合はDisallowを外すのが先である。
- 本来載せたいページが含まれていたら、Disallowを修正し、URL検査ツールで再クロールを促すのが当日中の対応である。
Search Consoleのページのインデックス登録レポートを開いたら、「robots.txtによりブロックされましたが、インデックスに登録しました」という項目に数百、数千のURLが並んでいた。エラーの赤ではなく黄色の警告なので放置したいが、本当に大丈夫なのか判断がつかない。Web担当や広告運用を兼務していると、この場面で手が止まる方は多いはずです。
結論から言うと、この警告は「ブロックを設定したのに外部や内部のリンクからURLだけ登録された」という状態を示すもので、すべてを直す必要はありません。パラメータ付きURLやカートのような機能URLなら放置が正解になることが多く、直すべきなのは「本来は検索に出したいページが巻き込まれている場合」と「どうしても出したくない情報がある場合」の2つです。
この記事では、URLを「放置・クロール許可・noindexに切り替え・削除」の4つに仕分ける判断表を中心に、robots.txtとnoindexの使い分け、併用で詰むパターン、広告パラメータURLとAdsBotの扱いまでを順に整理します。

「robots.txtによりブロックされましたが、インデックスに登録しました」とはどういう状態?
この警告は、GooglebotがrobotsのDisallowによってページ本文を読めない一方で、リンクなどからURLの存在を知り、URLだけをインデックスに登録した状態を指します。ページの中身は見られていないのに、URLという「名前」だけは索引に載っている、というイメージです。
robots.txtはクロールの制御で、インデックスの制御ではない
robots.txtとは、検索エンジンのクローラーに「このURLを取りに来ないでほしい」と伝えるためのテキストファイルです。制御できるのはクロール(取得)であって、インデックス登録(検索結果に載せるか)ではありません。Google検索セントラルのドキュメントでも、robots.txtは検索結果から除外する手段ではないと明記されています。
ここが最大の誤解ポイントです。「Disallowを書いた=検索に出ない」と考えて設定した担当者ほど、この警告に驚きます。
検索結果では説明文なしで表示される
本文を読めていないため、仮にこのURLが検索結果に出ても、スニペット(説明文)は表示されません。タイトルもURLやリンクのアンカーテキストから推測されたものになりがちです。site:検索で該当URLを調べて、説明文が空欄なら、この状態だと判断できます。
「ブロック済み」との違い
レポートには似た名前で「robots.txtによってブロックされました」という項目もあります。こちらはURLがインデックスに登録されていない状態で、意図どおりにブロックできているケースです。つまり「ブロックされましたが、インデックスに登録しました」は、ブロックが効いたうえでURLだけ登録された、中間的な状態という違いになります。
なお、クロールされていない点では「検出 - インデックス未登録」とも似ています。両者の違いは「検出 - インデックス未登録」との違いで整理しています。
この警告は放置していい?直すべきURLの見分け方
 URLを種類ごとに仕分けていく
警告の件数が多くても、URLの種類が広告パラメータ・絞り込み・カート・管理画面なら放置でよく、本来検索に出したいページや公開したくない情報が含まれる場合だけ対処が必要です。件数ではなく、中身で見ます。
まず、4つの対処に仕分ける判断表です。
| URLの種類 | 表示回数(検索パフォーマンス) | 対処 |
|---|---|---|
| 広告パラメータ(gclid、utm)、並び替え、絞り込み | ほぼゼロ、site:でのみ見える | 放置 |
| カート追加、ログイン、管理画面 | ゼロ | 放置(ブロック維持) |
| 本来は載せたいページ(商品・記事・サービス) | 表示回数が伸びない、または少ない | クロール許可(Disallow修正) |
| 載せたくないが検索に出てしまっているページ | 表示回数がある | noindexに切り替え(Disallowを外す) |
| 緊急で今すぐ消したい情報 | 問わない | 削除ツール+恒久対応 |
放置してよいURL(パラメータ・カート・絞り込み・管理画面)
Search Engine Journalの記事「Why Google Indexes Blocked Web Pages」では、John Muellerがボットの作った存在しないクエリパラメータURLについて、site:検索でしか見えず一般ユーザーの検索には出ないので気にしなくてよいと回答したと紹介されています。判断の軸は件数ではなく、実際の検索結果に出ているかどうかです。
同じくSearch Engine Journalの「Google Explains Why URLs Blocked By Robots.txt Can Still Be Indexed」では、WooCommerceのカート追加URLが約5.1万件この状態になった事例が取り上げられています。Muellerは、インデックス不要なURLなのでブロックしたままでよく、通常の検索結果に出る可能性も低いと答えたとのことです。
日本のShopifyやWordPressのECサイトでも、カート・並び替え・絞り込みURLは同じ構造で大量に出ます。「件数が多い=危険」ではなく、機能のためのURLは放置で正解、というのが国内でも通用する整理だと考えます。
直すべきURL(本来は載せたいページ・公開したくないページ)
直すべきは2種類です。ひとつは、商品ページ、サービスページ、ブログ記事など、本来は検索流入が欲しいページがDisallowに巻き込まれているケース。説明文がないまま表示されると、クリック率が下がります。もうひとつは、会員限定ページや社内資料のように、検索に出てはいけないものが出ているケースです。後者は単なる警告ではなく、情報管理の問題として扱ってください。
Search Consoleの表示回数とsite:検索で影響を確かめる
確認の手順は短く済みます。レポートの該当項目からURL一覧をエクスポートし、種類ごとにグループ分けします。次に、検索パフォーマンスのページ別で表示回数を見ます。表示回数がほぼゼロでsite:検索にしか出ないグループは放置、表示回数があるグループだけを次の章以降で対処する、という流れです。URLが数千件あっても、仕分けると実際に動くのは数十件程度に収まることが多いと言われます。
なぜrobots.txtでブロックしたのにインデックスされるのか
原因の大半は、ブロックしたURLに対して外部リンクや内部リンク、サイトマップからGoogleが存在を知ったことです。Disallowが効いていないのではなく、効いたうえでURLだけが登録されています。
リンクから発見されて登録される仕組み
Googlebotはクロールを禁止されても、他のページに貼られたリンクからURLを発見できます。外部リンクや内部リンクが多いURLほど、本文なしでも「存在するURL」として索引に載りやすくなります。広告運用者が見るgclid付きURLや、SNSで共有されたutm付きURLがこの警告に並ぶのも、リンクとして流通したからです。
サイトマップに含めたまま
見落とされやすいのがサイトマップです。サイトマップに載せたURLをDisallowしていると、「載せてほしい」と「来ないでほしい」を同時に伝えることになり、矛盾した状態になります。サイトマップの取得自体でつまずく場合は、サイトマップ「取得できませんでした」の切り分けも合わせて確認してください。robots.txtがサイトマップの取得に影響するケースもあります。
user-agentグループの優先順位による想定外の挙動
Search Engine Journalの「Google Says Why It May Ignore Robots.txt」では、robots.txtにGooglebot専用のuser-agentグループがあると、Googlebotはそのグループだけに従い、*のルールは無視すると説明されています。たとえば次のような記述です。
User-agent: *
Disallow: /cart/

User-agent: Googlebot
Disallow: /admin/この場合、Googlebotは/admin/だけを守り、/cart/はブロックされません。*側にだけ書いたつもりのルールが、Googlebotには届いていない状態です。「ブロックしたはずのURLがクロールされている」というズレの原因として、実務で見落とされやすい点だと思います。
robots.txtとnoindexの違いは?併用すると消えない理由
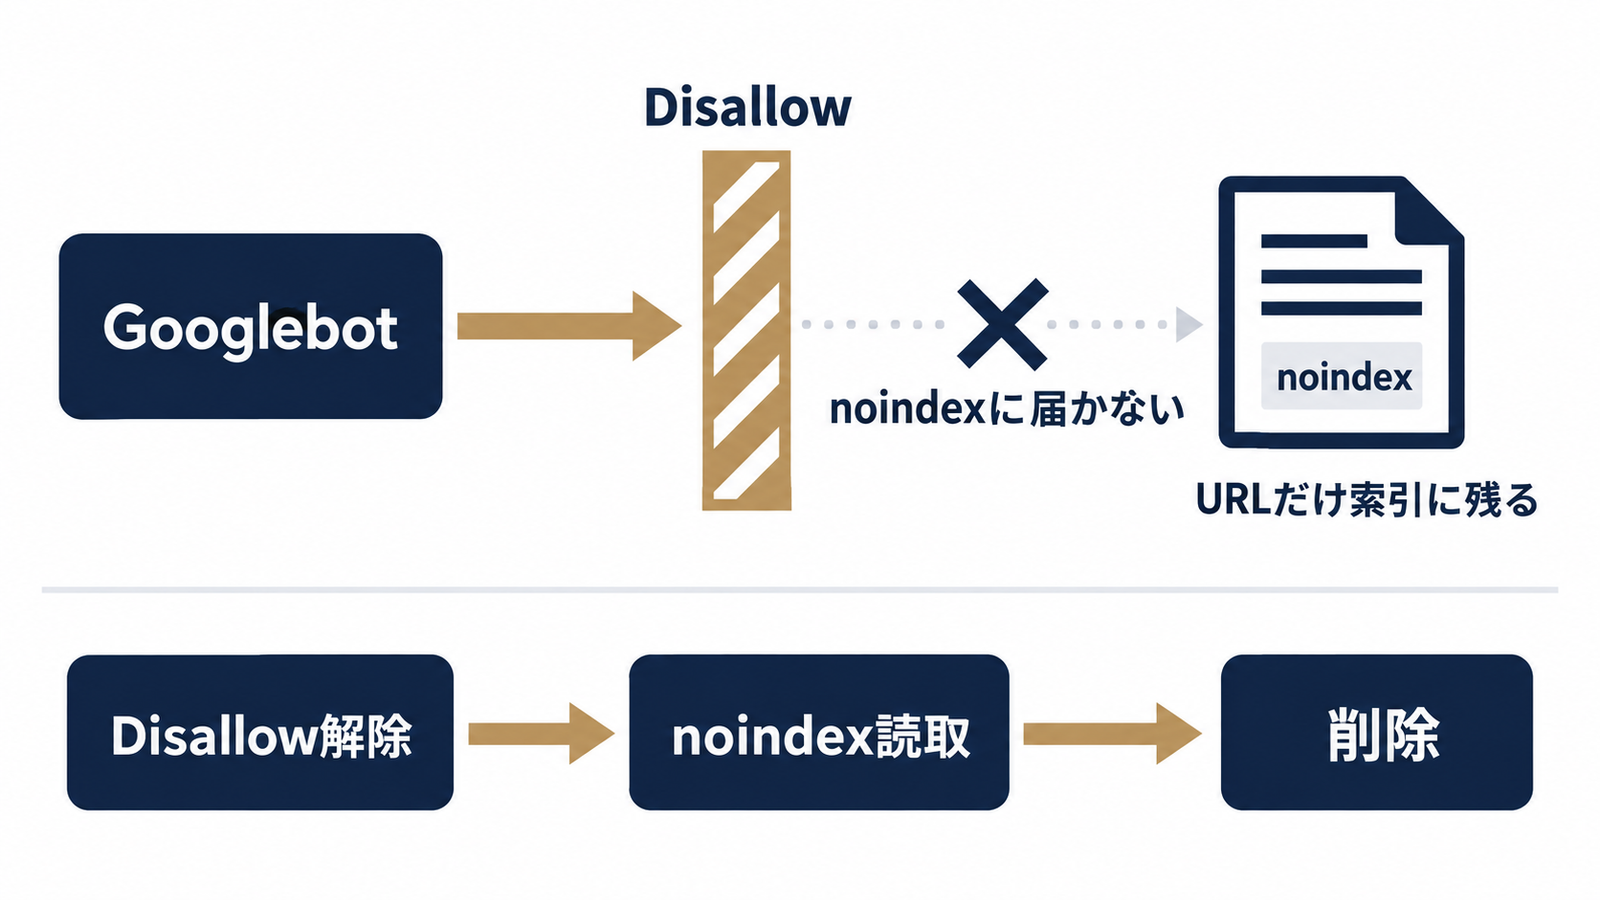 図1: Disallow併用でnoindexが届かない流れ
robots.txtはクロールの可否を決め、noindexはインデックスの可否を決めます。役割が別なので、検索結果から消したいならnoindex、取得を止めたいならrobots.txtと使い分けます。そして両方を同じURLに設定すると、noindexが読まれません。
仕組みは単純です。noindexはページの中(HTMLやHTTPヘッダー)に書かれた指示です。Disallowでクロールが止まっていると、Googlebotはその指示を読みに行けません。結果、URLはインデックスに残り続けます。PPC Landの「Google may index pages blocked by robots.txt」でも、Muellerがnoindexだけであればrobots.txtでブロックしなくても機能すると述べたと紹介されています。消したいなら先にDisallowを外す、という一見逆説的な手順が正しいわけです。
robots.txt・meta robots・X-Robots-Tagの比較表
| 手段 | 書く場所 | 制御するもの | noindexとして機能するか |
|---|---|---|---|
| robots.txt(Disallow) | サイトのルート直下 | クロール | しない |
| meta robots タグ | HTMLの<head>内 | インデックス登録 | する(noindex) |
| X-Robots-Tag HTTPヘッダー | サーバーの応答ヘッダー | インデックス登録 | する |
PDFや画像はX-Robots-Tagで指定する
PDFや画像にはHTMLの<head>がないため、meta robots タグを置けません。この場合はサーバー設定でX-Robots-Tag HTTPヘッダーにnoindexを返します。ここでも条件は同じで、そのファイルのパスをDisallowしていないことが前提です。
インデックスさせたいページの直し方
本来載せたいページがブロックされていたら、robots.txtのDisallowを修正し、URL検査ツールで再クロールを依頼します。手順自体は当日中に終わる作業です。
- robots.txtを開き、該当URLに当たるDisallowの行を特定する。
Disallow: /blogのように前方一致で広く効いている行が原因になりやすい。 - 該当の行を削除または範囲を狭めて保存し、サーバーへ反映する。WordPressならSEO系プラグインの設定画面、Shopifyなら編集に制約があるので後述の注意を確認する。
- Search ConsoleのURL検査ツールに該当URLを入れ、「公開URLをテスト」でクロール可能になったことを確認する。
- 「インデックス登録をリクエスト」を押す。
robots.txtテスターでの確認
以前はSearch Consoleに「robots.txtテスター」がありましたが、現在は提供が終了し、代わりに設定メニューの「robots.txt」レポートで取得状況やエラーを確認する形になっています(2026年時点)。ルールの当たり判定は、URL検査ツールの公開URLテストで「robots.txtによりブロックされていますか」の表示を見るのが確実です。
Shopifyについては、Search Engine Landの解説記事で、管理画面からrobots.txtを自由に編集しにくく、海外ではCloudflare Workersやリバースプロキシで回避する方法も紹介されていると言われます。ただし日本の中小ECには運用負荷が高く、通常は参考情報にとどめるのが現実的です。
修正を検証してから反映までの目安
レポート上の「修正を検証」ボタンを押すと、Googleが再確認を始めます。ただし完了までは数日から数週間かかるのが一般的で、押した当日に件数が減ることはありません。当日中にやるのは検証の開始まで、と割り切ってください。
インデックスから消したいページの直し方
 消えない理由に気づいて納得
消したいページは、Disallowを外す→noindexを付ける→消えたことを確認する→必要なら再ブロックする、の順に進めます。順序を逆にすると、冒頭で述べたとおり詰みます。
具体的には、まずrobots.txtから該当のDisallowを外します。次に、meta robots タグ(<meta name="robots" content="noindex">)かX-Robots-Tagを設定します。Googlebotが再クロールしてnoindexを読むと、レポートから消えます。URL検査ツールでインデックス登録の状態が「登録されていません」に変わったのを確認したら、クロール負荷を減らしたい場合に限りDisallowを戻します。戻さなくて困ることは通常ありません。
削除ツールは一時的な非表示(約6か月)
Search Consoleの削除ツールは、検索結果からURLを一時的に非表示にする機能で、効果は約6か月です。恒久的な削除ではないので、期間が過ぎると復活する可能性があります。恒久的に消すなら、noindexか、404/410の返却が必要です。削除ツールは「緊急で今すぐ隠したい」ときの時間稼ぎと位置づけるのが妥当です。
非公開にしたい情報はパスワード保護(Basic認証)にする
個人情報や社外秘資料のように、見られては困る情報にnoindexは不十分です。noindexは検索に出さない指示であって、URLを知っている人のアクセスを防ぎません。この場合はBasic認証などのパスワード保護をかけ、そもそも取得できない状態にします。
内部リンクとサイトマップから外す
URLを再発見されないよう、内部リンクとサイトマップからも外します。サイトマップに残したままだと、消えたはずのURLの存在を何度も知らせることになります。また、外部リンクが残る限り再登録されうるため、件数が減らないときは外部リンクの有無を疑ってください。
広告用LP・パラメータ付きURLはどう扱う?
gclidやutmが付いた広告用URLは、この警告に出ても通常は放置で構いません。ただし、広告LPのパスそのものをDisallowしている場合は、AdsBotとの関係を確認する必要があります。
Disallow: /*? の影響範囲
Disallow: /*?は、URLに?を含むすべてのページをクロール対象外にします。gclid、utm、絞り込み、並び替えのパラメータ付きURLがまとめて対象になるため、警告に大量に並ぶ典型パターンです。一方で、?付きの検索結果ページや、パラメータで内容が変わる商品ページまで巻き込むこともあります。範囲を確かめるため、警告のURL一覧に本来載せたいページが混じっていないかを必ず見てください。
広告LPをnoindexにするか、canonicalで正規化するか
広告専用のLPを検索に出したくない場合は、noindexが選択肢になります。一方、パラメータ違いの同一ページなら、canonicalで正規URLを示す方法が標準です。その仕組みは代替ページ(適切なcanonicalタグあり)で詳しく扱っています。ここで注意したいのは、Disallowしたページのcanonicalは読まれないという点です。canonicalで整理するなら、そのURLはクロールを許可しておく必要があります。
AdsBotはuser-agent: * のルールに従わない
AdsBot-Googleは、User-agent: *のルールに従いません。広告のリンク先を審査するボットで、明示的に名前を指定したルールだけに従います。前述のSearch Engine Journalの記事でも、AdsBotは*に従わないため広告LPの審査では別途の確認が必要と説明されています。
実務では、*でDisallowしている広告LPでも、AdsBotは審査のためにアクセスできるのが通常です。逆に、AdsBot-Googleを名指しでDisallowすると、LPの審査が通らなくなる恐れがあります。リンク先の不具合が出た場合は、Google広告「リンク先が機能していません」も併せて確認してください。
なお、リダイレクト経由のURLが警告に出ている場合は、「ページにリダイレクトがあります」の判断が参考になります。取得済みなのに登録されないタイプの警告は、「クロール済み - インデックス未登録」の対処で整理しています。
よくある質問
Q:robots.txtでブロックしたページにnoindexを付けても消えないのはなぜ?
Disallowによってクロールできないため、Googlebotがnoindexを読めないからです。いったんDisallowを外して再クロールさせ、noindexが認識されてインデックスから消えたのを確認してから、必要に応じて再ブロックしてください。
Q:この警告は検索順位に悪影響がありますか?
サイト全体の評価に、通常は影響しません。確認すべきなのは、本来載せたいページがブロックに巻き込まれていないかという一点です。パラメータURLやカートなどの機能URLだけなら、気にしなくて構いません。
Q:削除ツールで消せば終わりですか?
終わりではありません。削除ツールは検索結果からの一時的な非表示で、効果は約6か月です。恒久的に消すなら、noindexを付けるか、404/410を返す必要があります。
Q:「修正を検証」をしても件数が減らないのはなぜ?
再クロールに時間がかかるうえ、外部リンクが残っていれば再び登録されるためです。件数の増減よりも、検索パフォーマンスの表示回数や、実際の検索結果に出ているかで判断してください。
Q:広告のgclid付きURLがこの状態になっていたら直すべき?
通常は放置で構いません。クロールを許可できるなら、canonicalで正規URLを示しておけば十分です。広告の計測にも影響しません。
真策堂では、Search Consoleの警告を放置・修正のどちらに倒すか、広告LPとSEOの設定をどう整理するかといった観点で、ご相談を受けています。robots.txtの設計や仕分けに迷ったときは、お気軽にお問い合わせください。
- SEO・コンテンツ戦略
Search Consoleの「ソフト404」の原因と対処|在庫切れ・検索結果0件・正常なページが誤判定される時の切り分け方
Search Consoleのソフト404は、在庫切れ・検索結果0件・正常なページの誤判定でそれぞれ対処が違います。原因を6類型で切り分ける判断表、404との違い、放置してよいケース、修正を検証の待ち方まで手順でまとめました。
- SEO・コンテンツ戦略
Search Consoleのサイトマップ「取得できませんでした」の原因と対処|URL・形式・robots.txt・サーバー応答の4層切り分け
Search Consoleでサイトマップが「取得できませんでした」「読み込めませんでした」と出る原因を、URL・形式・robots.txt・サーバー応答の4層で切り分けます。保留・検出0件との見分け方、待つべき期間、技術的に正常でも消えない時の考え方まで解説します。
- SEO・コンテンツ戦略
「検出 - インデックス未登録」が増える・減らない原因と対処|「クロール済み」との違いと放置してよいURLの見分け方
Search Consoleの「検出 - インデックス未登録」が減らない原因を、クロール容量と需要の2分岐で切り分けます。クロール済みとの違い、放置してよいURLの判断表、新規記事が反映されない時のリクエストの使い方、待つ期間の目安まで、当日中に方針を決められる手順で解説します。