「noindexタグによって除外されました」が設定してないページに出る原因と対処|プラグイン・HTTPヘッダー・ステージング設定の残りを切り分ける手順
Search Consoleに設定した覚えのない『noindexタグによって除外されました』が出たときの原因と対処を解説。URL検査でメタタグかHTTPヘッダーかを1分で見分け、WordPressの設定、プラグイン、X-Robots-Tag、ステージング設定の残りを順に切り分けます。外した後に何日待つかの目安も整理しました。
この記事のポイント
- 「noindexタグによって除外されました」は、HTMLを触っていなくてもCMS設定・プラグイン・HTTPヘッダー・配信環境から付く。
- Search Consoleの URL検査で「インデックス登録を許可?」の文言を見れば、メタタグ由来かヘッダー由来かを1分で分けられる。
- ブラウザで見えないnoindexは、curl -I と -A Googlebot の2回比較で、ヘッダーの出し分けまで含めて見抜ける。
- noindexを外した後は、再クロールの依頼と「検証を開始」を行い、重要度の低いページは数週間から数か月待つ前提で動く。
- 再発防止は、メタ・ヘッダー・robots.txt・canonicalを確認するデプロイ前チェックを制作会社への発注条件に入れて行う。
Search Consoleを開いたら、設定した覚えのない「noindexタグによって除外されました」が並んでいる。ソースを開いても noindex の文字は見当たらない。ここで手が止まる担当者は多いはずです。
noindexタグによって除外されました、と表示される原因は、HTMLに書かれたタグだけではありません。CMSの全体設定、SEOプラグイン、サーバーやCDNが付けるHTTPヘッダー、ステージング環境の設定の持ち越しなど、「設定してない」つもりの場所から付くケースが現実にはかなりあります。
この記事では、出どころを HTML・CMS設定・プラグイン/テーマ・HTTPヘッダー・配信環境の5層に分け、確認の速い順に潰していく手順を整理します。外した後に何日待つか、いつ次の手を打つかの目安、制作会社に渡せるデプロイ前チェックまで含めます。
設定してないのに「noindexタグによって除外されました」と出るのはなぜ?
設定した覚えがないのに「noindexタグによって除外されました」と出るのは、noindexの指示がHTMLのメタタグ以外にも、CMS・プラグイン・HTTPレスポンスヘッダー・配信環境から付与されるためです。noindexとは、Googleに「このページを検索結果に載せないでください」と伝える指示のことです。Google Search Central の「Block Search indexing with noindex」でも、robots メタタグと X-Robots-Tag の効果は同じと説明されています。
つまり、ソースに noindex が無いことは、noindex が無いことの証明になりません。最初にやるのは原因探しではなく、そのURLの除外が意図したものかどうかの仕分けです。
放置してよい除外と、直すべき除外
Google Search Console の「ページのインデックス登録」レポートから該当URLを書き出して、次のように分けます。
| URLの種類 | 判断 |
|---|---|
| カート、会員ページ、サンクスページ、検索結果ページ | 放置してよい。むしろ除外が望ましい |
| タグ・日付アーカイブ、薄いカテゴリページ | サイト方針次第。意図した除外なら放置 |
| 記事、サービスページ、商品ページ、トップページ | 直す。検索流入の入口が消えている |
| 広告の遷移先LP | 自然検索で拾いたいかで判断。指名検索の受け皿なら直す |
一覧を眺めて「これは外してほしくない」と感じたURLが、調査の対象です。
影響が大きいケース
重要記事が数本だけなら、個別ページの設定を疑えば足ります。一方で、同じディレクトリや同じテンプレートのURLが一斉に出ているなら、テンプレート・プラグイン・ヘッダーの共通設定が原因です。トップページを含めてサイト全体が出ている場合は、WordPressの全体設定かステージング設定の持ち越しをまず疑います。数日で表示件数が急に増えたなら、直前のリリースや移行作業を時系列で確認してください。
まず1分で確認:noindexはメタタグとHTTPヘッダーのどちらから来ているか
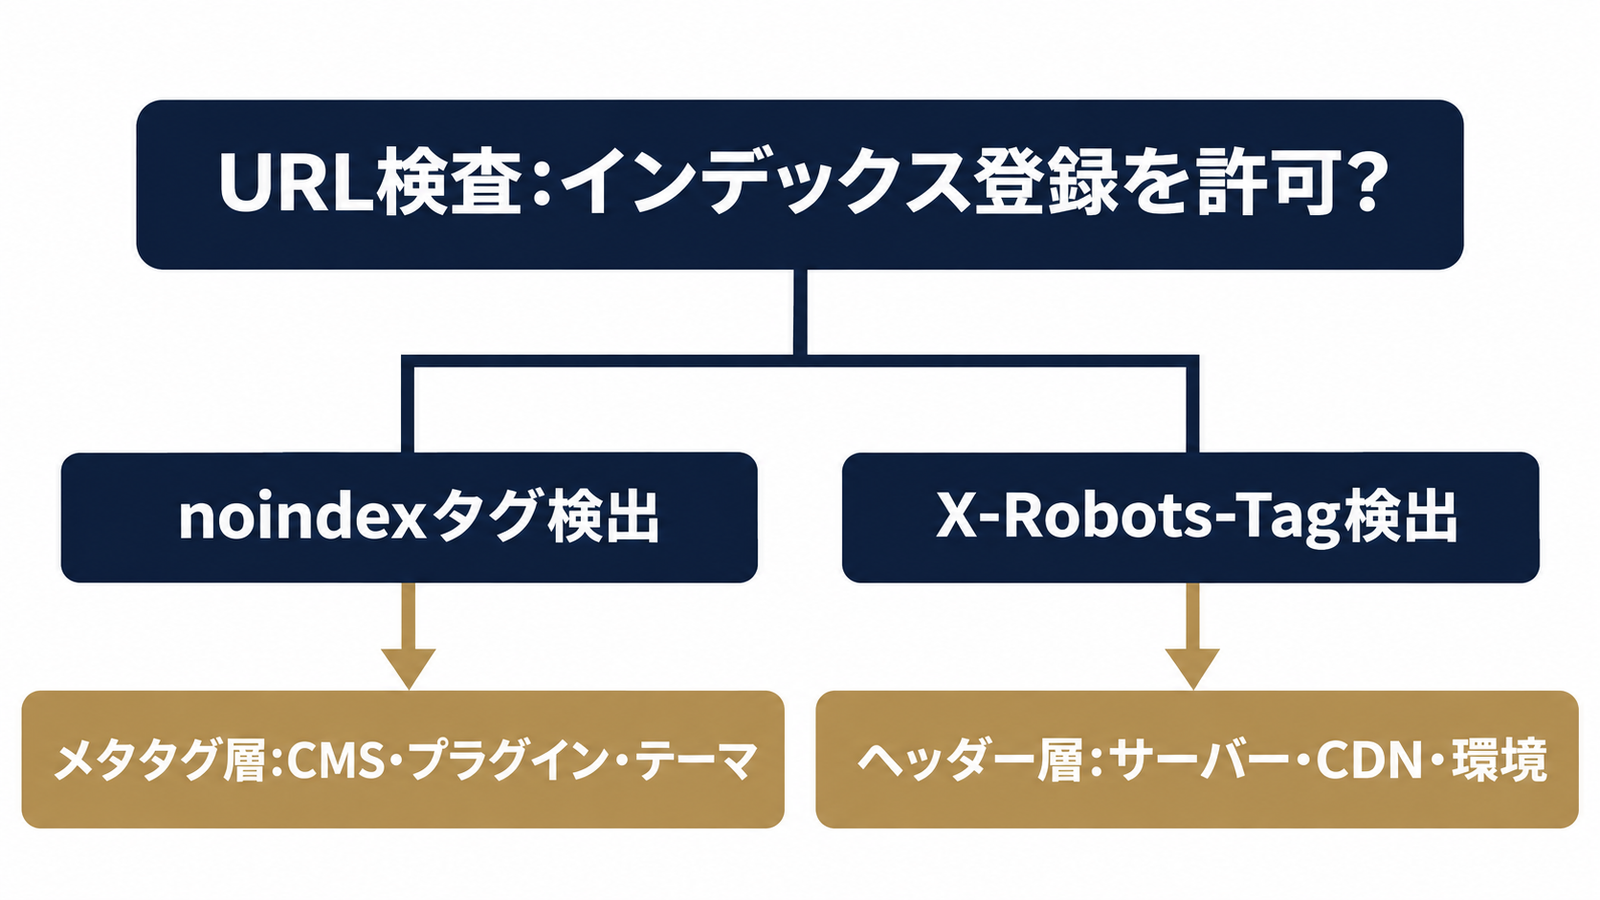 図1: noindexの出どころを切り分ける判断ツリー
noindexの出どころは、Search Console の URL検査にある「インデックス登録を許可?」の文言で、メタタグかHTTPヘッダーかを1分で分けられます。ここで分岐が決まれば、以降は片方の層だけを見ればよくなります。
URL検査の「インデックス登録を許可?」の読み方
URL検査ツールに対象URLを入れ、「ページのインデックス登録」の欄を開きます。「インデックス登録を許可?」の表示は、2026年時点では概ね次の2通りです。
- 「いいえ: ‘noindex’ タグが検出されました」→ HTML内の robots メタタグが読まれている。第3章へ
- 「いいえ: ‘noindex’ が ‘X-Robots-Tag’ HTTP ヘッダーで検出されました」→ ヘッダー由来。第4章・第5章へ
文言は画面の更新で変わることがあるので、「タグ」と「X-Robots-Tag」のどちらが書かれているかで読んでください。
ライブテストとインデックス済みバージョンの差を見る
URL検査には、Googleが過去に取得した状態(インデックス済み)と、今この瞬間の状態(公開URLをテスト)があります。両者で結果が違えば、noindexはすでに消えているが、Googleがまだ古い状態を見ているだけの可能性があります。逆にライブテストでもnoindexが出るなら、今も付いています。ライブテストの「HTML」タブでは、Googlebotが受け取ったHTMLを確認できます。ここに noindex があれば、ブラウザの表示がどうであれ、Googleには見えています。
「ページのインデックス登録」レポートから対象URLを書き出す
個別に調べる前に、レポートの「noindexタグによって除外されました」を開いてURLをエクスポートします。ディレクトリ、記事種別、投稿日、PDFや画像などの拡張子でパターンを見ると、原因の層がかなり絞れます。全部同じディレクトリならテンプレートかサーバー設定、特定の投稿タイプだけならプラグインのコンテンツタイプ設定、というように当たりが付きます。
メタタグ由来のときはどこを見る?CMS設定・SEOプラグイン・テーマの確認順
 CMS設定とプラグインを順に確認する
メタタグ由来のnoindexは、WordPressなら「全体設定→コンテンツタイプ別→個別ページ→テーマ」の順に確認すると最短で見つかります。広い範囲に効く設定から順に見るのがコツです。
WordPress「検索エンジンでの表示」のチェックが外れない・戻る原因
WordPressの管理画面にある「設定」→「表示設定」の「検索エンジンでの表示」で「検索エンジンがサイトをインデックスしないようにする」にチェックが入っていると、サイト全体に noindex が付きます。まずここを見ます。
チェックを外して保存しても戻る場合、設定画面の外で上書きされています。よくある原因は次のとおりです。
- ステージング・複製系のプラグインが、複製や同期のたびにこの設定を有効にする
- ホスティング会社のステージング機能が、本番への反映時に設定を持ち込む
- テーマや独自プラグインのコードで、設定値を強制している
切り分けは単純で、プラグインを一度すべて無効化し、標準テーマ(Twenty系など)に切り替えて、チェックが戻るかを見ます。戻らなくなったら、有効化を1つずつ戻して犯人を特定します。本番サイトで試す場合は、アクセスの少ない時間帯に行ってください。
Yoast・AIOSEOなどのコンテンツタイプ単位のnoindex
Yoast SEO や All in One SEO には、投稿タイプやタクソノミー単位で「検索結果に表示するか」を決める設定があります。Yoast SEO なら「設定」の「コンテンツタイプ」「タクソノミー」にあたる画面です。ここで「固定ページ」や「カスタム投稿」が非表示になっていると、そのタイプ全部に noindex が付きます。個別ページの詳細設定(高度な設定)も合わせて見てください。
一覧の件数が数十〜数百URLで一斉に出ているなら、個別ページを順に開くより、まずこのタイプ単位の設定を疑うのが速いです。
メンテナンスモード・Coming Soon系プラグインの残り
リニューアル中に使ったメンテナンスモードやComing Soon系のプラグインが、公開後も有効なまま残る事故があります。画面上は通常表示に見えても、プラグインが noindex を出し続けていることがあります。使っていないなら無効化ではなく削除まで行い、再度URL検査で確認します。
JSでnoindexを外す実装はGoogleに効かないことがある
Search Engine Land では、2025年12月のGoogleのドキュメント更新を受けて、元のHTMLに noindex があるとレンダリングやJavaScript実行がスキップされることがある、と報じられています。つまり、HTMLには noindex を置き、JSで後から消す実装は、ブラウザでは noindex が無いのに、Googleには残るという状況を生みます。
日本の制作現場でも、SPAや一部のノーコードツールで同じ構造が起こり得ます。ブラウザの検証ツール(DevTools)で消えているのを見て安心せず、URL検査のライブテストで、Googlebotが受け取ったHTMLを必ず確認してください。
X-Robots-Tagでnoindexが付いているかを確認する方法
X-Robots-Tagとは、HTMLではなくHTTPレスポンスヘッダーでnoindexなどの指示を返す仕組みです。HTMLのソースには一切現れないため、ヘッダーを直接見る以外に確かめる方法がありません。
GSQi の Glenn Gabe 氏の記事「How To Check The X-Robots-Tag For Noindex Directives」では、メタタグだけを見る監査ではX-Robots-Tagが漏れること、そのため単体はURL検査、大量のURLはURL Inspection APIや拡張機能、クローラーのx-robots列と、規模で手段を使い分けるべきことが整理されています。DevToolsだけで済ませがちな日本の現場では、この「一括確認」の発想が抜けやすいと考えます。数百URL規模なら、Screaming Frog のようなクローラーでレスポンスヘッダーを収集し、X-Robots-Tag列で絞り込むのが現実的です。
DevToolsのNetworkタブで見る
Chromeで対象URLを開き、DevToolsの Network タブでリロードします。一番上のドキュメント(URLそのもの)を選び、「Headers」の「Response Headers」に x-robots-tag があるかを確認します。キャッシュ無効化にチェックを入れてから読み込むと、古い応答を見なくて済みます。
curl -I と curl -A Googlebot の結果を比べる
ブラウザでは見えないのにGoogleには付いている、という問題は、UAやホスト名でヘッダーが変わると起こります。次の2回を実行して比べてください。
curl -I https://example.com/対象のパス/
curl -I -A "Googlebot" https://example.com/対象のパス/
後者だけに x-robots-tag: noindex が出るなら、UA判定のルールがどこかにあります。なお、-A Googlebot は偽装した名乗りに過ぎず、IP検証をするCDNやWAFでは本物のGooglebotと同じ扱いにならないことがあります。差が出ないのに URL検査では出る場合は、最終判断を URL検査のライブテストに委ねてください。リダイレクトがあるなら curl -IL で最終到達先のヘッダーも見ます。
PDF・画像だけ除外される場合
PDFや画像にはメタタグを置けません。それでも除外されているなら、サーバーが拡張子単位でX-Robots-Tagを付けている可能性が高いです。<FilesMatch "\.(pdf|jpg)$"> のようなルールが .htaccess や nginx の設定に入っていないかを確認します。意図して付けたルールなら、そのままで構いません。
ステージングやプレビューの設定が本番に残っていないか確かめる
HTML・CMS・プラグインに無くHTTPヘッダーに出ているなら、原因は配信環境に残ったステージング用の設定です。ステージングやプレビューのために入れたnoindexが本番に出る事故は、リリース作業のたびに起こり得ます。PageCrawl.io のブログ記事でも、意図しないデインデックスの多くはステージング用の設定が本番に出ることが原因とされています。
.htaccess・nginxのヘッダー指定
Apacheなら .htaccess と、httpd.conf の Header set X-Robots-Tag の行を探します。nginxなら add_header X-Robots-Tag です。ステージングの設定ファイルをそのまま本番に上げた、というのが典型的な失敗です。.htaccessの書き方は.htaccessの書き方の記事に整理しているので、ヘッダー指定を直す際の参考にしてください。
Cloudflareなど、CDNのルールのホスト名一致
Cloudflare などのCDNでは、Transform Rules などでレスポンスヘッダーを付与できます。ホスト名の一致条件を「含む」にしていると、ステージング用のつもりのルールが本番ドメインにも当たります。ルール一覧で、ヘッダー追加の条件を、完全一致になっているかまで確認してください。
Vercel等のプレビュー環境に自動で付くヘッダー
Vercel のドキュメント「Are Vercel Preview Deployments indexed by search engines?」では、プレビューデプロイには既定で X-Robots-Tag: noindex が付くこと、本番の切り替え後は旧本番デプロイにも自動で付くことが説明されています。ホスト名の一致ルールを自前で書くと誤適用のおそれがある、とも警告されています。プレビューのURLが検索に出ないのは正しい動作ですが、本番ドメインに付いているなら、プロジェクトのドメイン割り当てや独自のヘッダー設定を疑います。JamstackやHeadless構成が増えるほど、ヘッダー由来のnoindexは日本でも増えると考えられます。
ステージングからの複製・移行で引き継がれた設定
ステージングを本番へ複製・移行すると、WordPressの表示設定、プラグインの設定、サーバー設定がまとめて持ち込まれます。リニューアル時は特に起きやすいので、サイトリニューアル時の引き継ぎチェックリストに、noindex確認の項目を加えておくと安全です。
noindexを外したのにインデックスされないときは何日待てばいい?
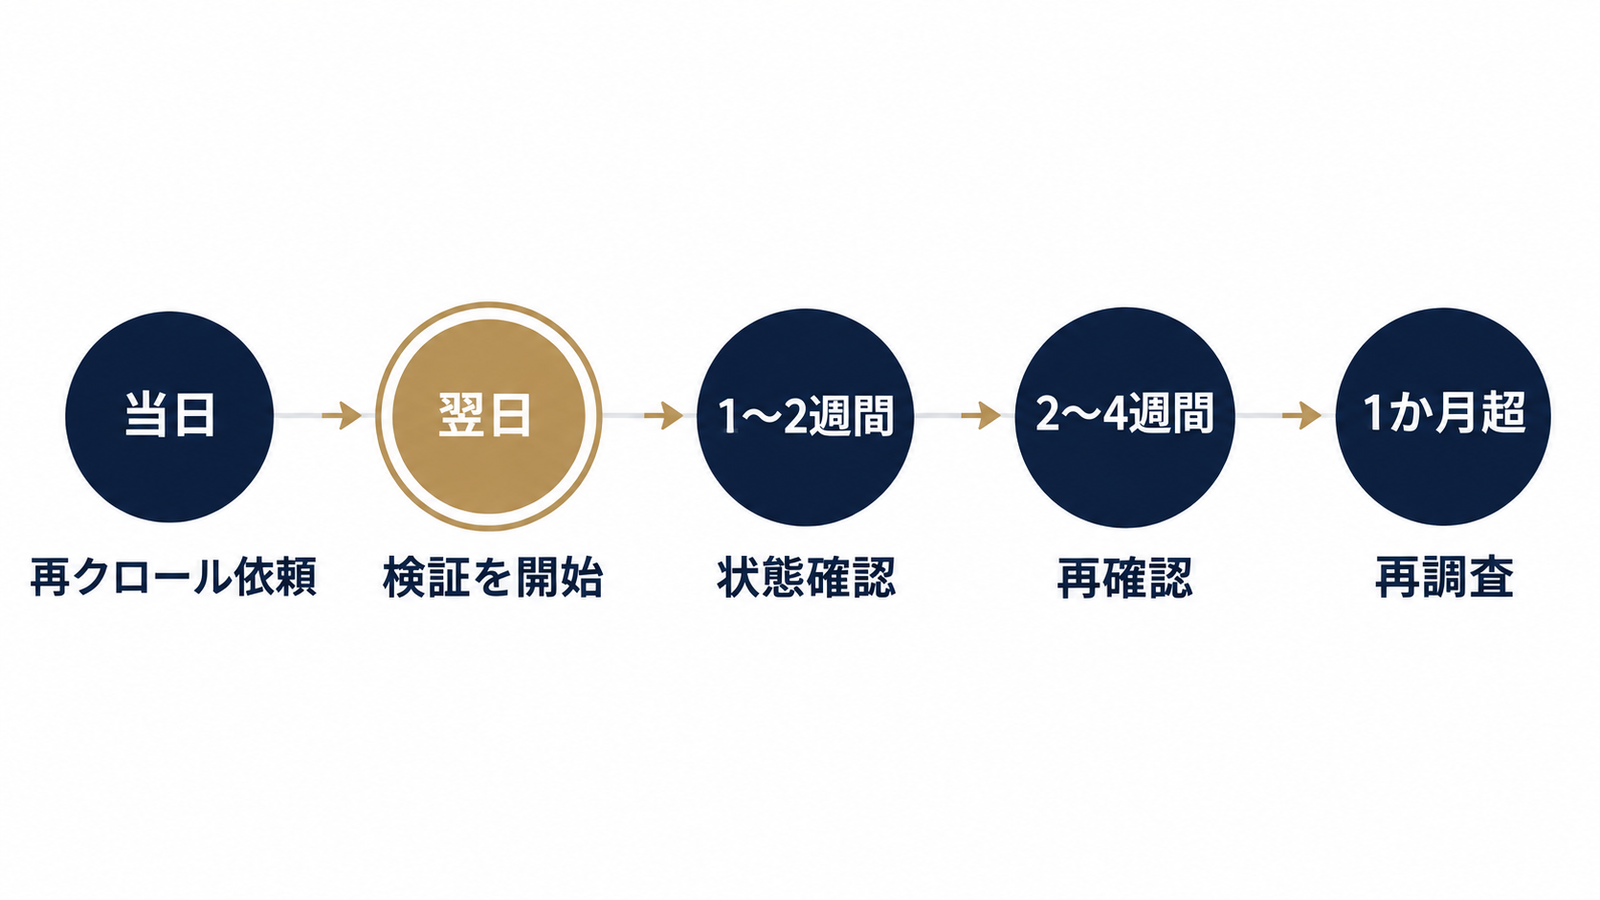 図2: noindex解除後の対応タイムライン
noindexを外した後は、再クロールの依頼と修正の検証を行い、数日〜数週間を目安に待ちます。重要度の低いページは、Google Search Central でも再クロールまで数か月かかることがあるとされています。
| 経過日数 | やること |
|---|---|
| 当日 | URL検査で公開URLをテストし、noindexが消えたことを確認。再クロールを依頼 |
| 当日〜翌日 | サイトマップを再送信。レポートで「検証を開始」 |
| 1〜2週間 | 重要URLのステータス変化を確認 |
| 2〜4週間 | 動かなければ、キャッシュ・robots.txt・削除ツールを再確認 |
| 1か月超 | 別の層の残りを再調査。それでも戻らなければ最終手段を検討 |
URL検査で再クロールを依頼し、レポートの「修正を検証」を始める
URL検査で「公開URLをテスト」を実行し、noindexが無いことを確認できたら、「インデックス登録をリクエスト」を押します。次に、「ページのインデックス登録」レポートの該当の除外理由を開き、「検証を開始」を押します。URLが多い場合、Googleは順に確認するため、結果が出るまで数日〜数週間かかります。
サイトマップを再送信する
サイトマップは、更新日(lastmod)を正しく更新したうえで再送信します。取得できないエラーが出るなら、サイトマップが取得できない時の切り分けを参照してください。
キャッシュ・robots.txt・削除ツールの残りを確認する
noindexを消しても戻らないときは、次の3点を確認します。CDNやサーバーのキャッシュが古い応答(noindex付き)を返していないか。robots.txt でブロックされていないか(ブロック中はGooglebotがページを読めず、noindexを外したことも伝わらない。詳しくはrobots.txtとnoindexの使い分けで補足しています)。Search Console の「削除」ツールで一時的な削除申請が残っていないか。
長期間戻らない場合の最終手段
1か月以上たっても進まないなら、noindexが本当に全層から消えているかを、curl とURL検査で再確認します。それでも戻らないなら、内部リンクを増やす、サイトマップに載せる、といった重要度のシグナルを強めます。最後の手段として、URLの変更(301リダイレクトでの新URL公開)を検討する場合もありますが、評価の引き継ぎを伴うので、最後に回してください。
インデックス登録が進んだ後に、別のステータスへ移ることもあります。その場合は「クロール済み - インデックス未登録」の対処と「検出 - インデックス未登録」が減らない原因も確認してください。
広告LPやサイト全体が除外されていた場合の影響はどこまで出る?
noindexが影響するのは、Googleの自然検索への掲載だけです。広告の配信そのものは止まりませんが、指名検索の受け皿が消えるという別の損失が出ます。
noindexでも広告の配信自体は可能
Google広告の審査と、検索インデックスの登録は別の仕組みです。LPにnoindexが付いていても、広告の配信自体は可能と考えられます。ただし、LPの品質評価や審査は別の基準で見られるため、noindexが原因で承認や評価が変わると決めつけず、広告側の診断メッセージを個別に確認してください。
指名検索の受け皿が消えるリスク
広告を見て社名やサービス名で検索し直す人は多く、その検索結果にLPや公式サイトが出なくなるのが実害です。サイト全体が除外された場合は、広告をクリックせず自然検索で比較検討していた層を取りこぼします。広告の成果が落ちたときに、広告設定だけを見て原因を探すと、見落としやすい点です。
再発を防ぐには?リリース前チェックとnoindexの監視
 リリース前にチェックして安心
再発防止には、制作会社に渡すデプロイ前チェックリストと、ヘッダーまで含めた定期監視の2つを用意します。PageCrawl.io のブログでは、共通テンプレートの差分、CDNルールのホスト名一致、CMSの複製を監視し、デプロイ直後に検知して即ロールバックする「リグレッション監視」という設計が紹介されています。発注側がチェックの仕組みを持てば、制作会社任せのリリースでも事故を防げます。
デプロイ前チェックリスト(メタ・ヘッダー・robots.txt・canonical)
発注仕様書に入れておくと、そのまま運用できます。発注の仕様書は制作会社に渡す発注仕様書の記事も参考にしてください。
- 主要URL(トップ、サービス、LP、記事)の robots メタタグに noindex が無い
- 同じURLの
curl -Iとcurl -I -A "Googlebot"に X-Robots-Tag: noindex が無い - robots.txt が
Disallow: /になっていない - canonical が本番ドメインの自URLを指している(ステージングのURLでない)
- WordPressの「検索エンジンでの表示」のチェックが外れている
- サイトマップが本番URLを列挙している
- リリース直後に、上記を再実行した結果を共有する
Search Consoleの通知と定期クロールで検知する
Search Console は、インデックス登録の問題をメールで通知しますが、検知は後追いで遅れがちです。リリースの直後と週次で、Screaming Frog などのクローラーを使い、主要URLを巡回して、メタタグとX-Robots-Tagの両方を見る運用が安心です。リリース前後の差分を比較する習慣があれば、数日の遅れが数時間で気づけます。
よくある質問
Q:noindexを外したのにインデックスされないのはなぜですか?どれくらい待てばいいですか?
Googleが再クロールして、noindexが消えたことを確認する必要があるためです。重要度が低いページは数か月かかることもあります。URL検査での再クロール依頼と「検証を開始」を行ったうえで、キャッシュ・robots.txt・削除ツールの残りを確認してください。
Q:WordPressの「検索エンジンがサイトをインデックスしないようにする」のチェックが外れない・勝手に戻るのはなぜですか?
プラグインやテーマが設定を上書きしているか、ステージング系の機能が複製のたびに有効化している可能性が高いです。プラグインをすべて無効化し、標準テーマに切り替えて戻るかを見て、1つずつ戻して原因を特定します。wp-config.php などの定数による強制も確認してください。
Q:ページのソースにnoindexが無いのに除外されるのはなぜですか?
X-Robots-Tagヘッダーによる指定か、JavaScriptによるHTMLの書き換えが考えられます。curl -I でヘッダーを、URL検査のライブテストで Googlebot が受け取ったHTMLを確認すれば、どちらかが分かります。
Q:robots.txtでブロックしているページにnoindexを付けても効きますか?
効きません。ブロックされたページはクロールされず、noindexも読まれないためです。検索結果から外したいなら、robots.txtでのブロックを解いてクロールを許可し、noindexを付けます。
Q:PDFや画像だけが「noindexタグによって除外されました」になるのはなぜですか?
メタタグを置けないファイルには、サーバーがX-Robots-Tagで指定していることが多いためです。.htaccessやnginxの拡張子単位のルールを確認してください。
Q:noindexが付いたLPでもGoogle広告は配信できますか?
配信は可能で、noindexが影響するのは自然検索だけです。ただし、指名検索の結果にLPが出なくなる点に注意してください。
noindexの出どころは、HTML・CMS・プラグイン・HTTPヘッダー・配信環境のどこにあるか、画面だけでは分かりにくいものです。真策堂では、こうした切り分けやデプロイ前チェックの設計について、ご相談を受けています。原因が絞れない場合や、制作会社への依頼内容を整理したい場合は、お気軽にお問い合わせください。
- SEO・コンテンツ戦略
Search Consoleの「ソフト404」の原因と対処|在庫切れ・検索結果0件・正常なページが誤判定される時の切り分け方
Search Consoleのソフト404は、在庫切れ・検索結果0件・正常なページの誤判定でそれぞれ対処が違います。原因を6類型で切り分ける判断表、404との違い、放置してよいケース、修正を検証の待ち方まで手順でまとめました。
- SEO・コンテンツ戦略
「robots.txtによりブロックされましたが、インデックスに登録しました」の原因と対処|noindexとの使い分けと放置してよいURLの見分け方
Search Consoleの「robots.txtによりブロックされましたが、インデックスに登録しました」の原因と対処を解説。放置してよいURLの判断表、robots.txtとnoindexの違い、併用すると消えない理由、広告パラメータURLの扱いまで、当日中に方針を決められる手順でまとめました。
- SEO・コンテンツ戦略
Search Consoleのサイトマップ「取得できませんでした」の原因と対処|URL・形式・robots.txt・サーバー応答の4層切り分け
Search Consoleでサイトマップが「取得できませんでした」「読み込めませんでした」と出る原因を、URL・形式・robots.txt・サーバー応答の4層で切り分けます。保留・検出0件との見分け方、待つべき期間、技術的に正常でも消えない時の考え方まで解説します。